32.7 Variable neighbourhood search
Parte 4 · Algoritmi euristici · Capitolo 32 · Capitolo 32: Metaeuristiche · Dispensa, volume 4 (PDF) · Slide (1/2) · Slide (2/2) · Esercizi: Metaeuristiche · App: TSP: simulated annealing e tabu search
La variable neighbourhood search (indicata con \(VNS\)) usa una successione di intorni \(N_1,N_2,\dots,N_{k_{\max}}\) di dimensione crescente. Dall'ottimo locale corrente estrae una soluzione casuale in \(N_k\) (shaking), le applica una ricerca locale, e si sposta sul nuovo ottimo locale se è migliore, ripartendo da \(k=1\); altrimenti prova l'intorno successivo, più grande, \(N_{k+1}\).
- Lo pseudocodice di \(VNS\) per \(P\,||\,C_{\max}\), dove \(N_k\) contiene gli assegnamenti ottenuti con \(k\) mosse e la ricerca locale è MOVEDESCENT, è il seguente:
Algoritmo: Variable neighbourhood search per \(P\,||\,C_{\max}\)
-
La \(VNS\) è stata proposta da Mladenovic e Hansen (1997). Si basa su tre osservazioni: un ottimo locale per un intorno non è necessariamente un ottimo locale per un altro; un ottimo globale è un ottimo locale per ogni intorno; e gli ottimi locali di intorni diversi sono spesso vicini fra loro.
-
Lo shaking diversifica, e la dimensione \(k\) controlla quanto: un \(k\) piccolo esplora le soluzioni vicine all'ottimo locale corrente, un \(k\) più grande va più lontano solo quando quelle più vicine hanno fallito. La ricerca locale intensifica. Tornare a \(k=1\) dopo ogni miglioramento concentra la ricerca vicino alla nuova soluzione, migliore.
-
Anche la variable neighbourhood descent (\(VND\)) del capitolo «Ricerca locale» usa più intorni, ma in modo deterministico: li esplora completamente, uno dopo l'altro, e si ferma in una soluzione che è un ottimo locale per tutti. La \(VNS\) esplora gli intorni grandi solo per campioni casuali, ed è questo che rende utilizzabili intorni molto grandi; la ricerca locale dentro la \(VNS\) può essere essa stessa una \(VND\).
-
Qui \(N_k\) contiene gli assegnamenti ottenuti spostando \(k\) lavori (o meno, se lo stesso lavoro è estratto due volte). Poiché uno swap di due lavori è la combinazione di due spostamenti, \(N_2\) contiene l'intorno swap: lo shaking con \(k=2\) può riprodurre gli swap che l'intorno move non vede.
32.7.1 Esempio
Esempio 32.7: \(VNS\) sull'istanza di riferimento di \(P\,||\,C_{\max}\)
Partiamo dalla soluzione LPT, con carichi \((11,8,8)\), e usiamo \(k_{\max}=3\) e \(seed=1\) (numeri casuali \(0.0000\), \(0.1315\), \(0.7556\), \(0.4587\), \(0.5328\), \(0.2190\), \(0.0470\), \(0.6789\)). MOVEDESCENT non cambia la soluzione LPT, che è un ottimo locale per l'intorno move (Esempio 32.5). Ogni spostamento casuale usa due numeri: \(j=1+\lfloor 7u\rfloor\) e \(g=1+\lfloor 2u\rfloor\).
-
Iterazione 1, \(k=1\): il lavoro \(j=1+\lfloor 7\cdot 0.0000\rfloor=1\) passa da \(M_1\) alla prima altra macchina (\(g=1+\lfloor 2\cdot 0.1315\rfloor=1\)), \(M_2\): carichi \((6,13,8)\). MOVEDESCENT sposta il lavoro \(6\) da \(M_2\) a \(M_1\): carichi \((9,10,8)\), \(C_{\max}=10\), migliore di \(11\). La nuova soluzione \(J_1=\{5,6,7\}\), \(J_2=\{1,2\}\), \(J_3=\{3,4\}\) viene accettata, e \(k=1\).
-
Iterazione 2, \(k=1\): il lavoro \(j=1+\lfloor 7\cdot 0.7556\rfloor=6\) passa da \(M_1\) a \(M_2\) (\(g=1+\lfloor 2\cdot 0.4587\rfloor=1\)): carichi \((6,13,8)\). MOVEDESCENT riporta il lavoro \(6\) su \(M_1\) e restituisce la soluzione corrente, che non è migliore: \(k=2\).
-
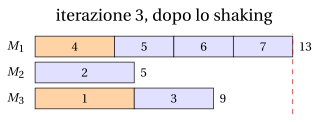
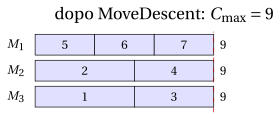
Iterazione 3, \(k=2\): il lavoro \(j=1+\lfloor 7\cdot 0.5328\rfloor=4\) passa da \(M_3\) alla prima altra macchina \(M_1\) (\(g=1+\lfloor 2\cdot 0.2190\rfloor=1\)); poi il lavoro \(j=1+\lfloor 7\cdot 0.0470\rfloor=1\) passa da \(M_2\) alla seconda altra macchina \(M_3\) (\(g=1+\lfloor 2\cdot 0.6789\rfloor=2\)): carichi \((13,5,9)\). MOVEDESCENT sposta il lavoro \(4\) da \(M_1\) a \(M_2\): carichi \((9,9,9)\). La soluzione viene accettata, e poiché \(C_{\max}=9=\LB\) la ricerca si ferma: \(VNS(I)=9=z(I)\).
Rispetto alla soluzione corrente dell'iterazione \(3\), i due spostamenti casuali e la discesa hanno scambiato i lavori \(1\) e \(4\): uno swap, che l'intorno move di MOVEDESCENT non può eseguire.
- Su PCM15, dalla soluzione LPT (\(73\)) e con al più \(300\) iterazioni, la \(VNS\) dà i seguenti makespan per \(seed=1,\dots,10\), e il numero di iterazioni eseguite:
| \(seed\) | \(1\) | \(2\) | \(3\) | \(4\) | \(5\) | \(6\) | \(7\) | \(8\) | \(9\) | \(10\) |
|---|---|---|---|---|---|---|---|---|---|---|
| \(k_{\max}=1\): \(C_{\max}\) | \(69\) | \(70\) | \(70\) | \(70\) | \(69\) | \(69\) | \(69\) | \(69\) | \(70\) | \(69\) |
| iterazioni | \(27\) | \(300\) | \(300\) | \(300\) | \(48\) | \(59\) | \(20\) | \(43\) | \(300\) | \(13\) |
| \(k_{\max}=2\): \(C_{\max}\) | \(70\) | \(69\) | \(69\) | \(69\) | \(69\) | \(70\) | \(69\) | \(70\) | \(70\) | \(69\) |
| iterazioni | \(300\) | \(41\) | \(126\) | \(285\) | \(33\) | \(300\) | \(31\) | \(300\) | \(300\) | \(26\) |
| \(k_{\max}=3\): \(C_{\max}\) | \(70\) | \(69\) | \(69\) | \(69\) | \(69\) | \(69\) | \(69\) | \(70\) | \(70\) | \(69\) |
| iterazioni | \(300\) | \(32\) | \(38\) | \(29\) | \(26\) | \(11\) | \(25\) | \(300\) | \(300\) | \(25\) |
- Con \(k_{\max}=3\), la \(VNS\) raggiunge l'ottimo \(69\) in \(7\) esecuzioni su \(10\), di solito in poche decine di iterazioni; la migliore tabu search della Sezione 32.5.2 richiedeva una durata tabu calibrata con cura. Quando la \(VNS\) fallisce, la ricerca è bloccata a \(70\): lo shaking esplora al più tre mosse di distanza, e l'ottimo è più lontano. Si possono aggiungere un \(k_{\max}\) più grande, o delle ripartenze, al prezzo di più iterazioni.
Avanti: 32.8 GRASP