Come uscire da un ottimo locale · Simulated annealing
Parte 4 · Algoritmi euristici · Capitolo 32 · Capitolo 32: Metaeuristiche · Dispensa, volume 4 (PDF) · Slide (1/2) · Slide (2/2) · Esercizi: Metaeuristiche · App: TSP: simulated annealing e tabu search
32.3 Come uscire da un ottimo locale
-
Una ricerca locale passa da una soluzione a un vicino migliore, e si ferma nel primo ottimo locale: una soluzione senza vicini migliori. Nel paesaggio della funzione obiettivo, scende fino al fondo della valle da cui parte, e lì rimane. È pura intensificazione.
-
Ripetere la ricerca locale da molte soluzioni di partenza (multi-start) esplora molte valli, ma ogni partenza ignora tutto ciò che è stato appreso prima, e le valli buone si trovano di solito vicino ad altre valli buone.
-
La tabella qui sotto elenca i modi per uscire da un ottimo locale; è la mappa del capitolo.
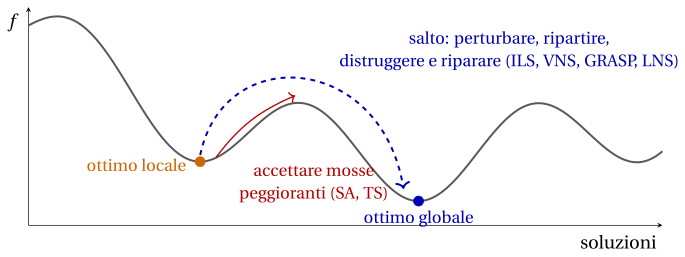
| come uscire | idea | metaeuristica |
|---|---|---|
| accettare mosse peggioranti a caso | un vicino peggiore è accettato con una probabilità che diminuisce con il peggioramento e con il tempo | simulated annealing (Sezione 32.4) |
| accettare mosse peggioranti in modo deterministico, con memoria | passare al miglior vicino anche se è peggiore, e vietare il ritorno alle soluzioni appena visitate | tabu search (Sezione 32.5) |
| perturbare l'ottimo locale e ripartire | applicare una modifica casuale che la ricerca locale non può annullare, e scendere di nuovo | iterated local search (Sezione 32.6) |
| cambiare l'intorno | quando la ricerca è bloccata, usare un intorno più grande, di cui l'ottimo locale non è più un ottimo locale | variable neighbourhood search (Sezione 32.7) |
| ripartire da una costruzione randomizzata | costruire una soluzione buona diversa a ogni ripartenza, e migliorarla | GRASP (Sezione 32.8) |
| distruggere e riparare | togliere una parte grande della soluzione e ricostruirla con un'euristica o un algoritmo esatto | large neighbourhood search (Sezione 32.9) |
| lavorare con una popolazione | combinare le parti di più soluzioni buone in soluzioni nuove | algoritmi genetici e memetici (Sezione 32.10) |
-
I primi due modi mantengono una sola soluzione corrente e cambiano la regola di accettazione della ricerca locale: escono dalla valle passando per soluzioni peggiori. I quattro successivi saltano: generano un nuovo punto di partenza, abbastanza lontano da lasciare la valle ma abbastanza vicino da conservare ciò che è buono. L'ultimo mantiene molte soluzioni contemporaneamente.
-
Ogni metaeuristica deve bilanciare intensificazione (scendere fino al fondo della valle corrente) e diversificazione (lasciarla per un'altra). Per ciascun metodo indichiamo quale componente fa che cosa.
-
Una metaeuristica è uno schema, non un algoritmo: per ottenere un algoritmo occorre scegliere la rappresentazione, gli intorni, la ricerca locale e i parametri, e queste scelte contano almeno quanto lo schema. Presentiamo ogni metaeuristica sui problemi in cui la sua idea è più naturale, non su tutti e quattro.
32.4 Simulated annealing
Il simulated annealing (indicato con \(SA\)) è una ricerca locale che sceglie un vicino casuale della soluzione corrente e vi si sposta se è migliore; se è peggiore, vi si sposta comunque con una probabilità che diminuisce con il peggioramento e con un parametro \(T\), la temperatura. La temperatura parte alta, così che all'inizio quasi ogni mossa è accettata, e viene abbassata gradualmente, così che alla fine sono accettate solo mosse miglioranti. Si restituisce la migliore soluzione visitata.
- Lo pseudocodice di \(SA\), per un problema di minimo con obiettivo \(f\) e intorno \(N\), è il seguente:
Algoritmo: Simulated annealing
- Il nome viene dalla metallurgia: l'annealing (ricottura) è il processo che scalda un metallo e lo raffredda lentamente, così che i suoi atomi si dispongano in uno stato di energia minima; raffreddato troppo in fretta, il metallo si blocca in uno stato disordinato di energia più alta. Kirkpatrick, Gelatt e Vecchi (1983) e, indipendentemente, Černy (1985) hanno proposto di simulare questo processo su un problema di ottimizzazione, con l'obiettivo \(f\) nel ruolo dell'energia. La regola di accettazione è quella usata da Metropolis et al. (1953) per simulare gli atomi.
Regola di accettazione di Metropolis. Alla temperatura \(T\), un vicino \(S'\) della soluzione corrente, con \(\delta=f(S')-f(cur)\), è accettato con probabilità
-
La probabilità si realizza estraendo \(v=\textsc{Rand}()\), uniforme in \((0,1)\), e accettando se \(v<e^{-\delta/T}\), il che accade con probabilità \(e^{-\delta/T}\).
-
Una mossa peggiorante è accettata più facilmente se il peggioramento \(\delta\) è piccolo, e se la temperatura \(T\) è alta. Per \(T\to\infty\) ogni mossa è accettata, e \(SA\) diventa una passeggiata casuale (pura diversificazione); per \(T\to 0\) sono accettate solo le mosse con \(\delta\le 0\), e \(SA\) diventa una ricerca locale con scelta casuale del vicino (pura intensificazione). Abbassare la temperatura porta gradualmente dal primo comportamento al secondo.
-
Le mosse con \(\delta=0\) sono sempre accettate: \(SA\) si muove liberamente sui plateau degli obiettivi piatti.
-
\(SA\) non si ferma mai in un ottimo locale: un ottimo locale viene lasciato appena una mossa peggiorante è estratta e accettata. Per questo la soluzione migliore visitata va memorizzata a parte: la soluzione corrente alla fine non è necessariamente la migliore.
-
A ogni iterazione si valuta un solo vicino casuale, non l'intero intorno: un'iterazione di \(SA\) costa pochissimo, e \(SA\) esegue molte più iterazioni di una ricerca locale. Per il TSP, una mossa 2-opt casuale si estrae numerando le \(M=\frac{n(n-3)}{2}\) mosse \((i,j)\) in ordine lessicografico e scegliendo quella in posizione \(1+\lfloor \textsc{Rand}()\cdot M\rfloor\); il suo \(\delta\) si calcola in \(O(1)\).
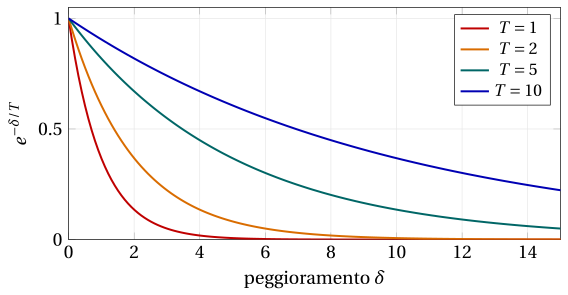
- La figura mostra la probabilità di accettazione in funzione del peggioramento, per quattro temperature. A \(T=10\) un peggioramento di \(5\) è accettato con probabilità \(e^{-0.5}\approx 0.61\); a \(T=1\) con probabilità \(e^{-5}\approx 0.007\). La temperatura ha la stessa unità di misura dell'obiettivo: \(T\) è «grande» o «piccola» solo rispetto ai valori tipici di \(\delta\).
32.4.1 Lo schema di raffreddamento e i parametri
-
Lo schema di raffreddamento è la successione delle temperature. Lo pseudocodice usa lo schema geometrico \(T\leftarrow\alpha T\), il più comune in pratica, con \(\alpha\) fra \(0.8\) e \(0.99\), e \(L\) mosse a ogni temperatura. Altri schemi sono quello lineare, \(T_k=T_0-k\beta\), e quello logaritmico, \(T_k=\frac{\Gamma}{\ln(k+1)}\), che conta nella teoria di \(SA\) ma è decisamente troppo lento in pratica.
-
Temperatura iniziale \(T_0\). Deve essere abbastanza alta da accettare all'inizio la maggior parte delle mosse peggioranti. Una regola comune fissa un tasso di accettazione iniziale obiettivo \(\chi_0\) (per esempio \(\chi_0=0.8\)), stima il peggioramento medio \(\bar\delta\) di un campione di mosse casuali, e pone \(T_0=-\bar\delta/\ln\chi_0\), così che \(e^{-\bar\delta/T_0}=\chi_0\).
-
Mosse per temperatura \(L\). Bisogna dare alla ricerca il tempo di adattarsi a ogni temperatura; \(L\) si prende spesso proporzionale alla dimensione dell'intorno.
-
Criterio di arresto. Lo pseudocodice si ferma quando \(T\le T_{\min}\). Con lo schema geometrico il numero di temperature è il più piccolo intero \(K\) con \(T_0\alpha^K\le T_{\min}\), cioè \(K=\big\lceil \ln(T_{\min}/T_0)/\ln\alpha\big\rceil\) quando il rapporto non è intero, e il numero di iterazioni è \(K\cdot L\). Altri criteri comuni si fermano dopo un certo numero di temperature senza mosse accettate, o a un limite di tempo.
-
Un raffreddamento lento (\(\alpha\) vicino a \(1\)) dà soluzioni migliori ma più iterazioni: i parametri scambiano qualità con tempo, come in ogni euristica.
32.4.2 Esempi
Esempio 32.3: \(SA\) con l'intorno 2-opt sull'istanza di riferimento del TSP
Partiamo dal giro calcolato dall'euristica nearest neighbour dalla città \(1\) nel capitolo «Euristiche costruttive», \(\sigma=(1,3,2,4,5)\) di lunghezza \(25\), con \(T_0=5\), \(\alpha=0.8\), \(L=2\) e \(T_{\min}=3\): le temperature sono \(5\), \(4\) e \(3.2\) (poi \(2.56\le 3\) ferma la ricerca), per un totale di \(6\) iterazioni. Le \(M=5\) mosse 2-opt su \(5\) città sono numerate
e i numeri casuali, con \(seed=1\), sono quelli della Sezione 32.2.2: il primo numero di ogni iterazione (\(u\)) sceglie la mossa \(1+\lfloor 5u\rfloor\), il secondo (\(v\)) serve nel test di accettazione.
| it | \(T\) | \(u\) | mossa | \(\delta\) | \(v\) | \(e^{-\delta/T}\) | decisione | giro corrente | \(L\) |
|---|---|---|---|---|---|---|---|---|---|
| \(1\) | \(5\) | \(0.0000\) | \(1:(1,3)\) | \(4\) | \(0.1315\) | \(0.4493\) | accetta | \((1,2,3,4,5)\) | \(29\) |
| \(2\) | \(5\) | \(0.7556\) | \(4:(2,5)\) | \(-7\) | — | — | accetta | \((1,2,5,4,3)\) | \(22\) |
| \(3\) | \(4\) | \(0.5328\) | \(3:(2,4)\) | \(2\) | \(0.2190\) | \(0.6065\) | accetta | \((1,2,4,5,3)\) | \(24\) |
| \(4\) | \(4\) | \(0.0470\) | \(1:(1,3)\) | \(-6\) | — | — | accetta | \((1,4,2,5,3)\) | \(18\) |
| \(5\) | \(3.2\) | \(0.6793\) | \(4:(2,5)\) | \(4\) | \(0.9347\) | \(0.2865\) | rifiuta | \((1,4,2,5,3)\) | \(18\) |
| \(6\) | \(3.2\) | \(0.3835\) | \(2:(1,4)\) | \(4\) | \(0.5194\) | \(0.2865\) | rifiuta | \((1,4,2,5,3)\) | \(18\) |
Alle iterazioni \(1\) e \(3\) viene accettato un giro peggiore (\(25\to 29\) e \(22\to 24\)), perché \(v\) è minore della probabilità di accettazione; alle iterazioni \(5\) e \(6\) la temperatura è più bassa, le mosse peggioranti hanno meno probabilità di essere accettate, ed entrambe sono rifiutate. Il giro migliore, \((1,4,2,5,3)\), è il giro ottimo \((1,3,5,2,4)\) percorso nel verso opposto: \(SA(I)=18=z(I)\).
- Su questa istanza piccola il giro ottimo è l'unico ottimo locale 2-opt fra i \(12\) giri, quindi anche una ricerca locale 2-opt lo raggiungerebbe: l'esempio mostra il meccanismo di \(SA\); la sua capacità di uscire dagli ottimi locali si vede su istanze con ottimi locali cattivi.
32.4.3 Soluzioni inammissibili: simulated annealing con penalità
- Per il KP, l'intorno flip di una soluzione vicina alla capacità contiene molte soluzioni inammissibili. Invece di scartarle, \(SA\) può visitarle, con una penalità sul peso in eccesso che le rende meno attraenti:
\(SA\) massimizza \(f_\beta\) su tutti gli \(x\in\{0,1\}^n\); il peggioramento di una mossa da \(x\) a \(y\) è \(\delta=f_\beta(x)-f_\beta(y)\), e la soluzione migliore si aggiorna solo con soluzioni ammissibili.
-
Su una soluzione ammissibile \(f_\beta\) è il profitto. Passando per una soluzione inammissibile, \(SA\) può raggiungere soluzioni ammissibili che non sono raggiungibili con soli flip ammissibili: la regione inammissibile fa da ponte fra le valli.
-
Il coefficiente di penalità \(\beta\) è un parametro: se è troppo piccolo la ricerca vaga nella regione inammissibile, dove il profitto è maggiore; se è troppo grande le soluzioni inammissibili non sono mai accettate, e il ponte è chiuso.
Esempio 32.4: \(SA\) con penalità sull'istanza di riferimento del KP
Partiamo da \(x=(1,0,1,0)\), la soluzione \(\{1,3\}\) dell'algoritmo greedy per efficienza, di profitto \(16\). È un ottimo locale per l'intorno flip (capitolo «Algoritmi euristici: definizioni»): i suoi vicini ammissibili hanno profitto \(6\) e \(10\). Usiamo \(\beta=3\), \(T_0=4\), \(\alpha=0.8\), \(L=2\), \(T_{\min}=2.5\) (temperature \(4\), \(3.2\), \(2.56\): \(6\) iterazioni) e \(seed=3\). A ogni iterazione \(u\) sceglie l'oggetto \(k=1+\lfloor 4u\rfloor\) da invertire, e \(v\) serve nel test di accettazione.
| it | \(T\) | \(u\) | \(k\) | \(y\) | \(\sum w_jy_j\) | \(f_3(y)\) | \(\delta\) | \(v\) vs \(e^{-\delta/T}\) | decisione |
|---|---|---|---|---|---|---|---|---|---|
| \(1\) | \(4\) | \(0.0000\) | \(1\) | \((0,0,1,0)\) | \(3\) | \(6\) | \(10\) | \(0.3946\ge 0.0821\) | rifiuta |
| \(2\) | \(4\) | \(0.2668\) | \(2\) | \((1,1,1,0)\) | \(12\) | \(14\) | \(2\) | \(0.3760<0.6065\) | accetta |
| \(3\) | \(3.2\) | \(0.5983\) | \(3\) | \((1,1,0,0)\) | \(9\) | \(17\) | \(-3\) | — | accetta |
| \(4\) | \(3.2\) | \(0.1411\) | \(1\) | \((0,1,0,0)\) | \(4\) | \(7\) | \(10\) | \(0.0366<0.0439\) | accetta |
| \(5\) | \(2.56\) | \(0.0379\) | \(1\) | \((1,1,0,0)\) | \(9\) | \(17\) | \(-10\) | — | accetta |
| \(6\) | \(2.56\) | \(0.1505\) | \(1\) | \((0,1,0,0)\) | \(4\) | \(7\) | \(10\) | \(0.5582\ge 0.0201\) | rifiuta |
All'iterazione \(2\) la ricerca passa alla soluzione inammissibile \((1,1,1,0)\), di peso \(12>9\): il suo profitto è \(23\) e il suo valore penalizzato \(23-3\cdot 3=14\), un peggioramento di \(2\) accettato con probabilità \(0.6065\). Da lì, togliendo l'oggetto \(3\) si ottiene la soluzione ammissibile \((1,1,0,0)\) di profitto \(17\): l'ottimo, \(SA(I)=17=z(I)\). L'iterazione \(4\) mostra che a questa temperatura anche un peggioramento di \(10\) può essere accettato, con una probabilità piccola; l'iterazione \(5\) torna all'ottimo.
32.4.4 Un esperimento sull'istanza media del TSP
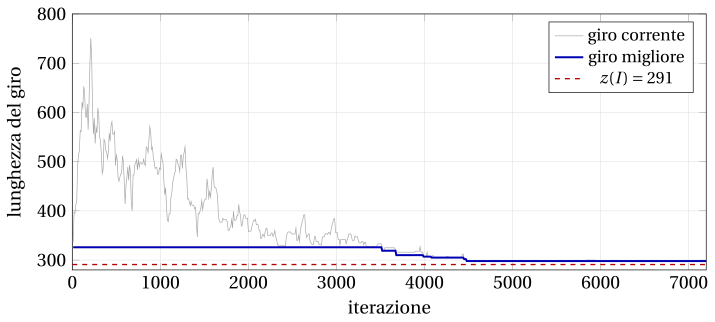
- Eseguiamo \(SA\) con l'intorno 2-opt su TSP20 (Esempio 32.1), dal giro nearest neighbour di lunghezza \(326\), con \(L=100\) e \(T_{\min}=0.5\). La figura mostra un'esecuzione, con \(T_0=20\), \(\alpha=0.95\) e \(seed=1\): la lunghezza del giro corrente (grigio) e del giro migliore (blu) lungo le \(7200\) iterazioni, ogni \(10\) iterazioni. I dati sono prodotti dal codice
C++del capitolo, nel suo notebook Colab.
-
All'inizio la temperatura è alta rispetto al peggioramento tipico di una mossa 2-opt, e il giro corrente diventa molto peggiore di quello di partenza (fino a lunghezza \(765\)): la ricerca è quasi una passeggiata casuale. Al diminuire di \(T\), sono accettate meno mosse peggioranti e il giro corrente scende in una valle; alla fine la ricerca è una ricerca locale. Il giro migliore, di lunghezza \(298\), è trovato all'iterazione \(4479\): è migliore dell'ottimo locale 2-opt (\(319\)), ma non è ottimo.
-
La tabella riporta, per \(10\) esecuzioni con \(seed=1,\dots,10\) e diversi parametri, il numero di iterazioni, la lunghezza minima, media e massima del giro migliore, e il numero di esecuzioni che raggiungono l'ottimo \(291\).
| \(\alpha\) | \(T_0\) | iterazioni | min | media | max | esecuzioni ottime |
|---|---|---|---|---|---|---|
| \(0.9\) | \(1\) | \(700\) | \(291\) | \(310.3\) | \(322\) | \(1\) |
| \(0.9\) | \(5\) | \(2200\) | \(291\) | \(297.3\) | \(305\) | \(4\) |
| \(0.9\) | \(20\) | \(3600\) | \(291\) | \(300.3\) | \(323\) | \(4\) |
| \(0.9\) | \(100\) | \(5100\) | \(291\) | \(297.8\) | \(311\) | \(3\) |
| \(0.95\) | \(1\) | \(1400\) | \(291\) | \(302.3\) | \(319\) | \(3\) |
| \(0.95\) | \(5\) | \(4500\) | \(291\) | \(294.3\) | \(298\) | \(5\) |
| \(0.95\) | \(20\) | \(7200\) | \(291\) | \(294.3\) | \(298\) | \(5\) |
| \(0.95\) | \(100\) | \(10400\) | \(291\) | \(293.2\) | \(299\) | \(7\) |
| \(0.99\) | \(1\) | \(6900\) | \(291\) | \(298.8\) | \(305\) | \(4\) |
| \(0.99\) | \(5\) | \(23000\) | \(291\) | \(291.7\) | \(298\) | \(9\) |
| \(0.99\) | \(20\) | \(36800\) | \(291\) | \(291.0\) | \(291\) | \(10\) |
| \(0.99\) | \(100\) | \(52800\) | \(291\) | \(291.0\) | \(291\) | \(10\) |
- Con \(T_0=1\) la temperatura è troppo bassa fin dall'inizio: sono accettate poche mosse peggioranti, e \(SA\) si comporta come una ricerca locale randomizzata. Un raffreddamento più lento (\(\alpha=0.99\)) passa più iterazioni in ogni intervallo di temperatura e raggiunge l'ottimo in quasi tutte le esecuzioni, al prezzo di molte più iterazioni. Una singola esecuzione dice poco: il confronto deve guardare la distribuzione su più semi, come ricordato nel capitolo «Algoritmi euristici: definizioni».
32.4.5 Proprietà
- A temperatura fissata \(T\), la successione delle soluzioni correnti di \(SA\) è una catena di Markov: la soluzione successiva dipende solo da quella corrente. Se l'intorno è simmetrico (\(S'\in N(S)\) se e solo se \(S\in N(S')\), con tutti gli intorni della stessa dimensione) e connesso (ogni soluzione può raggiungere ogni altra attraverso mosse), la catena ha un'unica distribuzione stazionaria, la distribuzione di Boltzmann:
-
Per due soluzioni \(S_1\) e \(S_2\), \(\frac{\pi_T(S_1)}{\pi_T(S_2)}=e^{(f(S_2)-f(S_1))/T}\): le soluzioni migliori sono più probabili, e tanto più quanto più bassa è la temperatura. Per \(T\to 0\), \(\pi_T\) si concentra sulle soluzioni ottime.
-
Hajek (1988) ha dimostrato che con lo schema logaritmico \(T_k=\frac{\Gamma}{\ln(k+1)}\), con \(\Gamma\) almeno pari alla profondità della valle più profonda che non contiene una soluzione ottima, la probabilità che la soluzione corrente sia ottima tende a \(1\). Il risultato è una garanzia al limite: il numero di iterazioni necessarie può superare il numero di soluzioni, e in pratica si usa lo schema geometrico, più veloce, senza garanzie.
Avanti: 32.5 Tabu search