17.3.2 Un secondo algoritmo di PD: Un'implementazione con liste
Parte 3 · Programmazione dinamica · Capitolo 17 · Capitolo 17: Zaino 0/1 (KP) · Dispensa, volume 3 (PDF) · Slide (1/2) · Slide (2/2) · Esercizi: Zaino 0/1 (KP) · App: Tabelle della PD per i problemi di zaino
-
Passo 1: calcolo del valore ottimo
-
L'algoritmo di PD di questa sezione memorizza un valore per ogni coppia formata da un oggetto e da un profitto obiettivo, cioè \((n+1)(P+1)\) valori in tutto. Molti di questi valori sono uguali a \(+\infty\), perché nessun sottoinsieme degli oggetti disponibili ha quel profitto totale.
-
Questa sottosezione descrive una diversa implementazione dello stesso algoritmo di PD. La decomposizione ricorsiva e la sottostruttura ottima sono quelle della formula \(\eqref{eq:2}\): cambia la struttura dati.
-
Invece di un'intera riga della matrice, memorizziamo solo le coppie ottenute effettivamente da un sottoinsieme di oggetti e, fra queste, solo quelle che possono portare a una soluzione ottima. Queste coppie sono tenute in una lista, una lista per ogni oggetto.
Uno stato è una coppia \((w,p)\), dove \(w\) è il peso totale e \(p\) è il profitto totale di un sottoinsieme di oggetti.
-
Il sottoinsieme vuoto dà lo stato \((0,0)\). Un sottoinsieme degli oggetti \(\{1,2,\dots,j\}\) dà lo stato ottenuto sommando i pesi e i profitti dei suoi oggetti.
-
Due sottoinsiemi diversi possono dare lo stesso stato, e in questo caso basta tenerne uno. Più in generale, uno stato si può scartare quando un altro stato è almeno altrettanto buono in entrambe le componenti.
Dati due stati \((w,p)\) e \((w',p')\) con \((w,p)\ne(w',p')\), lo stato \((w,p)\) domina lo stato \((w',p')\) se
\[ w\le w' \qquad \textrm{e} \qquad p\ge p'. \]Uno stato è non dominato se nessun altro stato lo domina.
-
Uno stato dominato si può scartare. Infatti, supponiamo che \((w,p)\) domini \((w',p')\) e sia \(S'\) un sottoinsieme degli oggetti rimanenti che si può aggiungere a \((w',p')\) senza superare la capacità.
-
Poiché \(w\le w'\), lo stesso sottoinsieme \(S'\) si può aggiungere anche a \((w,p)\) e, poiché \(p\ge p'\), il profitto totale risultante non è minore. Pertanto nessuna soluzione ottima va persa.
Per ogni \(j \in \{0,1,\dots,n\}\), sia \(L_j\) la lista degli stati non dominati che si possono ottenere selezionando un sottoinsieme degli oggetti \(\{1,2,\dots,j\}\), ordinata per peso strettamente crescente.
La formula ricorsiva per calcolare \(L_j\) è la seguente:
\[\begin{equation*} \label{eq:6} L_j= \left\{ \begin{array}{ll} \big\{(0,0)\big\} & \textrm{se $j=0$,}\\[2ex] \textrm{nd}\big(L_{j-1}\cup M_j\big) & \textrm{se $1\le j \le n$,} \end{array} \right. \tag{17.6} \end{equation*}\]dove \(\textrm{nd}(S)\) indica la lista degli stati non dominati di un insieme \(S\) di stati, e
\[ M_j=\big\{\,(w+w_j,\;p+p_j)\;:\;(w,p)\in L_{j-1}\,\big\}. \] -
Il processo di decomposizione ricorsiva della formula \(\eqref{eq:6}\) genera \(2\) sottoproblemi indipendenti per ogni stato di \(L_{j-1}\), corrispondenti alla scelta di selezionare o no l'oggetto \(j\). Se l'oggetto \(j\) non è selezionato, lo stato non cambia e appartiene a \(L_{j-1}\). Se l'oggetto \(j\) è selezionato, lo stato diventa \((w+w_j,p+p_j)\) e appartiene a \(M_j\).
-
Qui \(L_0=\{(0,0)\}\) perché l'unico sottoinsieme di un insieme vuoto di oggetti è il sottoinsieme vuoto.
-
Come nella formula \(\eqref{eq:2}\), la capacità dello zaino non compare nella ricorsione: la lista \(L_j\) raccoglie gli stati di tutti i sottoinsiemi degli oggetti \(\{1,2,\dots,j\}\), compresi quelli il cui peso totale supera la capacità.
-
Quindi ogni stato non dominato raggiungibile con gli oggetti \(\{1,2,\dots,j\}\) si costruisce combinando la decisione scelta sull'oggetto \(j\) con uno stato non dominato raggiungibile con gli oggetti \(\{1,2,\dots,j-1\}\).
\(\rightsquigarrow\) Sottostruttura ottima verificata!
-
Sottoinsiemi diversi degli oggetti \(\{1,2,\dots,j\}\) possono dare lo stesso stato, e uno stato può anche essere dominato da un altro. In entrambi i casi in \(L_j\) si tiene un solo stato, e tutti i sottoinsiemi che portano a esso vengono trattati insieme nelle iterazioni successive.
\(\rightsquigarrow\) Sottoproblemi sovrapposti verificati!
-
La capacità dello zaino si usa solo alla fine, esattamente come nella formula (17.5): fra gli stati di \(L_n\), solo quelli il cui peso totale non supera la capacità corrispondono a una soluzione ammissibile.
Il valore ottimo dell'istanza del KP è
\[\begin{equation*} \label{eq:7} \max \big\{\, p \;:\; (w,p)\in L_n,\ w\le c \,\big\}. \tag{17.7} \end{equation*}\] -
L'insieme della formula \(\eqref{eq:7}\) non è mai vuoto, poiché \((0,0)\in L_n\) e \(0\le c\), e quindi il massimo è sempre ben definito.
-
La lista \(L_j\) contiene in forma compressa l'informazione della riga \(j\) della matrice \({u}\):
\[ \min\big\{\,w \;:\; (w,p)\in L_j,\ p\ge q\,\big\}=\min_{q'\ge q}\ {u}[j][q'] \qquad \forall q \in \{0,1,\dots,P\}. \]I profitti obiettivo con valore \(+\infty\) nella riga non lasciano alcuno stato nella lista, e nemmeno un profitto obiettivo il cui peso minimo non è minore di quello di un profitto obiettivo più grande.
Esempio 17.20: Le liste di stati
Consideriamo l'istanza del KP dell'Esempio 17.13, con uno zaino di capacità \(c=5\) e i seguenti profitti e pesi:
\[ \begin{array}{l|rrr} \hline & {j = 1} & {j = 2} & {j = 3} \\ \hline {p_j} & {3} & {3} & {4} \\ {w_j} & {2} & {3} & {3} \\ \hline \end{array} \]Ogni fascia ombreggiata raccoglie gli stati di una lista. Un arco che entra nella fascia di \(L_j\) corrisponde alla decisione presa sull'oggetto \(j\): un arco orizzontale indica che l'oggetto \(j\) non è selezionato, mentre un arco obliquo indica che l'oggetto \(j\) è selezionato. Gli archi spessi danno gli stati di una soluzione ottima.
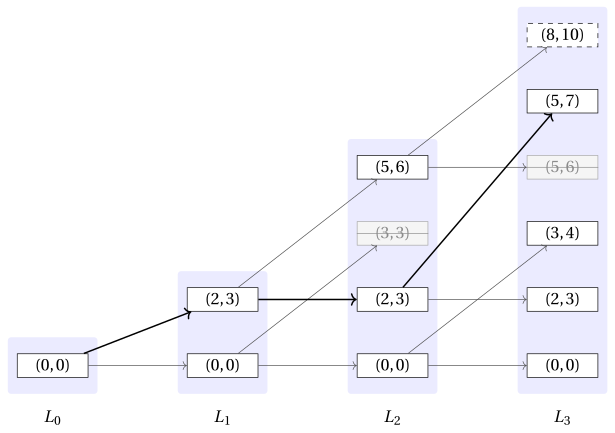
I due stati barrati sono dominati e quindi vengono scartati: \((3,3)\) è dominato da \((2,3)\) e \((5,6)\) è dominato da \((5,7)\). Lo stato \((8,10)\), con il bordo tratteggiato, ha un peso totale maggiore della capacità \(c=5\) dello zaino: resta nella lista, perché la capacità non si usa durante la ricorsione, e viene scartato solo dalla formula \(\eqref{eq:7}\).
-
La lista \(L_{j-1}\) e la lista \(M_j\) sono entrambe ordinate per peso crescente, perché \(M_j\) si ottiene da \(L_{j-1}\) aggiungendo lo stesso peso \(w_j\) a ogni stato. Pertanto l'unione della formula \(\eqref{eq:6}\) si calcola scorrendo contemporaneamente le due liste, come nella fusione di due liste ordinate.
-
Per descrivere l'ordine di scansione usiamo la seguente convenzione.
Lo stato \((w,p)\) precede lo stato \((w',p')\) se
\[ w<w' \qquad \textrm{o} \qquad \textrm{($w=w'$ e $p>p'$)}. \]- Se gli stati vengono scanditi in quest'ordine, uno stato è non dominato se e solo se il suo profitto è strettamente maggiore del profitto più grande degli stati già scanditi. Infatti, ogni stato già scandito ha un peso non maggiore, e quindi domina lo stato corrente non appena il suo profitto non è minore.
Questo è lo pseudocodice dell'algoritmo di PD con liste:
Algoritmo: DP2_Lists
Input: Un'istanza del KP data dal numero \(n\) di oggetti, dai vettori \(p[1..n]\) e \(w[1..n]\) dei profitti e dei pesi degli oggetti e dalla capacità \(c\) dello zainoOutput: Il valore ottimo dell'istanza del KP1Function DP2_Lists(\(n,p,w,c\))2\(L := \textnormal{new list containing the single state } (0,0)\)3for \(j := 1\) to \(n\) do4\(M := \textnormal{new empty list}\)5for \(h := 1\) to \(|L|\) do6accodare \((L[h].w + w[j],</div><div class="pc" style="--liv:3" id="box-101-kplist2-e"><span class="pc-n">7</span>L[h].p + p[j])<span class="arithmatex">\(a\)</span>M\)8end9\(L \leftarrow \textnormal{\tt Merge}(L,M)\)10end11\(z := 0\)12for \(h := 1\) to \(|L|\) do13if \(L[h].w \le c\) then14\(z \leftarrow L[h].p\)15end16end17return \(z\)Questo è lo pseudocodice della procedura che fonde due liste e scarta gli stati dominati:
Algoritmo: Merge
Input: Due liste \(L\) e \(M\) di stati, entrambe ordinate per peso crescenteOutput: La lista degli stati non dominati di \(L\cup M\), ordinata per peso crescente1Function Merge(\(L,M\))2\(R := \textnormal{new empty list}\)3\(h := 1\)4\(k := 1\)5\(\pi := -1\)6while \(h \le |L|\) o \(k \le |M|\) do7if \(k>|M|\) o (\(h\le |L|\) e \(L[h]\) precede \(M[k]\)) then8\((a,b) \leftarrow L[h]\)9\(h \leftarrow h+1\)10else11\((a,b) \leftarrow M[k]\)12\(k \leftarrow k+1\)13end14if \(b > \pi\) then15accodare \((a,b)\) a \(R\)16\(\pi \leftarrow b\)17end18end19return \(R\)-
La lista \(L\) è la lookup table: al termine dell'iterazione per l'oggetto \(j\), memorizza la lista \(L_j\).
-
La lista \(L\) si inizializza con il solo stato \((0,0)\), cioè con la lista \(L_0\).
-
Il ciclo esterno, sugli oggetti \(j \in \{1,2,\dots,n\}\), calcola una lista per ogni oggetto.
-
Il ciclo interno costruisce la lista \(M\) degli stati ottenuti selezionando l'oggetto \(j\). Qui nessuno stato viene scartato, perché la capacità dello zaino non si usa durante la ricorsione.
-
La procedura
Mergescorre contemporaneamente le due liste e tiene uno stato solo quando il suo profitto è strettamente maggiore del profitto più grande già accodato, memorizzato nella variabile ausiliaria \(\pi\). Il valore iniziale \(\pi=-1\) garantisce che il primo stato scandito venga sempre accodato. -
L'ultimo ciclo realizza la formula \(\eqref{eq:7}\). Gli stati di \(L\) hanno pesi strettamente crescenti e profitti strettamente crescenti, e quindi la variabile ausiliaria \(z\) termina con il profitto dell'ultimo stato il cui peso non supera la capacità dello zaino.
-
Infine, l'algoritmo restituisce il valore ottimo dell'istanza del KP, \(z\).
Esempio 17.21: Esecuzione dell'algoritmo di PD
Consideriamo l'istanza del KP dell'Esempio 17.13, con uno zaino di capacità \(c=5\) e i seguenti profitti e pesi:
\[ \begin{array}{l|rrr} \hline & {j = 1} & {j = 2} & {j = 3} \\ \hline {p_j} & {3} & {3} & {4} \\ {w_j} & {2} & {3} & {3} \\ \hline \end{array} \]Per ogni oggetto \(j\), la tabella riporta la lista \(M_j\) degli stati ottenuti selezionando l'oggetto \(j\) e la lista \(L_j\) risultante.
\[ \begin{array}{c|l|l} \hline {j} & {M_j} & {L_j} \\ \hline {0} & {-} & {\{(0,0)\}} \\ {1} & {\{(2,3)\}} & {\{(0,0),(2,3)\}} \\ {2} & {\{(3,3),(5,6)\}} & {\{(0,0),(2,3),(5,6)\}} \\ {3} & {\{(3,4),(5,7),(8,10)\}} & {\{(0,0),(2,3),(3,4),(5,7),(8,10)\}} \\ \hline \end{array} \]Per ogni stato scandito da
Merge, la tabella riporta il valore di \(j\), lo stato, la lista da cui è preso e l'operazione eseguita.\(j\) stato da Azione \(1\) \((0,0)\) \(L_{0}\) \(0>\pi=-1\): accodare \(1\) \((2,3)\) \(M_1\) \(3>\pi=0\): accodare \(2\) \((0,0)\) \(L_{1}\) \(0>\pi=-1\): accodare \(2\) \((2,3)\) \(L_{1}\) \(3>\pi=0\): accodare \(2\) \((3,3)\) \(M_2\) \(3\le\pi=3\): scartare (dominato) \(2\) \((5,6)\) \(M_2\) \(6>\pi=3\): accodare \(3\) \((0,0)\) \(L_{2}\) \(0>\pi=-1\): accodare \(3\) \((2,3)\) \(L_{2}\) \(3>\pi=0\): accodare \(3\) \((3,4)\) \(M_3\) \(4>\pi=3\): accodare \(3\) \((5,7)\) \(M_3\) \(7>\pi=4\): accodare \(3\) \((5,6)\) \(L_{2}\) \(6\le\pi=7\): scartare (dominato) \(3\) \((8,10)\) \(M_3\) \(10>\pi=7\): accodare L'ultimo ciclo scorre \(L_3\) e tiene il profitto dell'ultimo stato il cui peso non supera \(c=5\): gli stati \((0,0)\), \((2,3)\), \((3,4)\) e \((5,7)\) danno \(z\leftarrow 0\), \(z\leftarrow 3\), \(z\leftarrow 4\) e \(z\leftarrow 7\), mentre lo stato \((8,10)\) non causa alcun aggiornamento poiché \(8>5\). Pertanto il valore ottimo dell'istanza del KP è \(7\).
-
Dopo l'esecuzione dell'algoritmo di PD, la lista \(L\) contiene gli stati non dominati \(L_n\), ordinati per peso strettamente crescente e profitto strettamente crescente.
-
-
Passo 2: calcolo di una soluzione ottima
-
Per calcolare una soluzione ottima, cioè il vettore binario \((x_1,x_2,\dots,x_n)\), è necessario memorizzare alcune informazioni aggiuntive. La sola lista \(L_n\) dà il valore ottimo, ma non dice quali oggetti producono lo stato che lo raggiunge.
-
Per ogni oggetto \(j\) e ogni posizione \(h \in \{1,2,\dots,|L_j|\}\), oltre allo stato \(L_j[h]\), memorizziamo due valori:
-
\({\sigma}_j[h]\), che è uguale a \(1\) se l'oggetto \(j\) è selezionato nello stato \(L_j[h]\), ed è uguale a \(0\) altrimenti;
-
\({\rho}_j[h]\), che è la posizione in \(L_{j-1}\) dello stato da cui si ottiene \(L_j[h]\).
-
-
Uno stato preso da \(L_{j-1}\) dà \({\sigma}_j[h]=0\), mentre uno stato preso da \(M_j\) dà \({\sigma}_j[h]=1\). In entrambi i casi \({\rho}_j[h]\) è la posizione dello stato di \(L_{j-1}\) che lo ha generato.
-
L'algoritmo di PD deve anche conservare tutte le liste \(L_0,L_1,\dots,L_n\), e non solo l'ultima, perché la ricostruzione le ripercorre all'indietro.
Esempio 17.22: Calcolo delle informazioni aggiuntive
Consideriamo l'istanza del KP dell'Esempio 17.13. Per ogni oggetto \(j\) e ogni posizione \(h\), la tabella riporta lo stato \(L_j[h]\) e i valori memorizzati \({\sigma}_j[h]\) e \({\rho}_j[h]\).
\[ \begin{array}{c|c|c|c|c} \hline {j} & {h} & {L_j[h]} & {\sigma_j[h]} & {\rho_j[h]} \\ \hline {1} & {1} & {(0,0)} & {0} & {1} \\ {1} & {2} & {(2,3)} & {1} & {1} \\ \hline {2} & {1} & {(0,0)} & {0} & {1} \\ {2} & {2} & {(2,3)} & {0} & {2} \\ {2} & {3} & {(5,6)} & {1} & {2} \\ \hline {3} & {1} & {(0,0)} & {0} & {1} \\ {3} & {2} & {(2,3)} & {0} & {2} \\ {3} & {3} & {(3,4)} & {1} & {1} \\ {3} & {4} & {(5,7)} & {1} & {2} \\ {3} & {5} & {(8,10)} & {1} & {3} \\ \hline \end{array} \]Per esempio, lo stato \(L_3[4]=(5,7)\) ha \({\sigma}_3[4]=1\) e \({\rho}_3[4]=2\): si ottiene selezionando l'oggetto \(3\) a partire dallo stato \(L_2[2]=(2,3)\), poiché \(2+w_3=2+3=5\) e \(3+p_3=3+4=7\).
-
La ricostruzione parte dalla posizione \(\tilde h\) dello stato che raggiunge il massimo della formula \(\eqref{eq:7}\), cioè la posizione in cui l'ultimo ciclo di
DP2_Listsaggiorna \(z\) per l'ultima volta. In generale non è l'ultima posizione di \(L_n\), perché gli ultimi stati di \(L_n\) possono avere un peso totale maggiore della capacità dello zaino. -
Si ricostruisce poi una soluzione ottima scorrendo gli oggetti da \(j=n\) fino a \(j=1\), partendo da \(h=\tilde h\):
\[ \begin{array}{ll} x_j \leftarrow {\sigma}_j[h],\quad h \leftarrow {\rho}_j[h] & \textrm{per $j=n,n-1,\dots,1$.} \end{array} \] -
Si ottiene così il vettore \((x_1,x_2,\dots,x_n)\), dove \(x_j\) è uguale a \(1\) se l'oggetto \(j\) è selezionato in una soluzione ottima, e a \(0\) altrimenti.
Algoritmo: DP2_Lists_Reconstruct
Input: Il numero \(n\) di oggetti, la posizione \(\tilde h\) dello stato ottimo in \(L_n\) e i valori memorizzati \({\sigma}\) e \({\rho}\)Output: Una soluzione ottima dell'istanza del KP1Function DP2_Lists_Reconstruct(\(n,\tilde h,\sigma,\rho\))2\(x := \textnormal{new array}[1..n]\)3for \(j := 1\) to \(n\) do4\(x[j] \leftarrow 0\)5end6\(h := \tilde h\)7for \(j := n\) downto \(1\) do8\(x[j] \leftarrow {\sigma}_j[h]\)9\(h \leftarrow {\rho}_j[h]\)10end11return \(x\)Esempio 17.23: Calcolo di una soluzione ottima
Dopo l'esecuzione dell'algoritmo di PD sull'istanza dell'Esempio 17.13, l'ultima lista è
\[ L_3=\big\{(0,0),(2,3),(3,4),(5,7),(8,10)\big\} \]e il massimo della formula \(\eqref{eq:7}\) è raggiunto dallo stato \(L_3[4]=(5,7)\), quindi \(\tilde h=4\) e il valore ottimo è \(7\).
Possiamo ricostruire una soluzione ottima partendo da \(j=3\) e \(h=\tilde h=4\) come segue:
Iterazione \(j\) \(h\) \(L_j[h]\) \({\sigma}_j[h]\) \({\rho}_j[h]\) \(x[1]\) \(x[2]\) \(x[3]\) Azione \(-\) \(-\) \(-\) \(-\) \(-\) \(-\) 0 0 0 \(h=4\) \(1\) \(3\) \(4\) \((5,7)\) \(1\) \(2\) 0 0 1 \(h\leftarrow 2\) \(2\) \(2\) \(2\) \((2,3)\) \(0\) \(2\) 0 0 1 \(h\leftarrow 2\) \(3\) \(1\) \(2\) \((2,3)\) \(1\) \(1\) 1 0 1 \(h\leftarrow 1\) Quindi il vettore
\[ (1,0,1) \]è una soluzione ottima. Il valore ottimo corrispondente è \(3+4=7\).
-
17.3.3 Numero di passi
-
Indichiamo con \(S(n,P)\) il numero di passi eseguiti da
DP2_Listsnel caso peggiore, dove \(n\) è il numero di oggetti e \(P=\sum_{j=1}^{n}p_j\) è il profitto totale di tutti gli oggetti. -
Gli stati di una lista hanno profitti strettamente crescenti e ogni profitto appartiene a \(\{0,1,\dots,P\}\): pertanto \(|L_j|\le P+1\) per ogni \(j \in \{0,1,\dots,n\}\), e \(|M_j|=|L_{j-1}|\).
-
Per ogni oggetto,
DP2_Listsscorre una volta \(L_{j-1}\) per costruire \(M_j\) e poi chiamaMerge, che scandisce \(|L_{j-1}|+|M_j|\le 2(P+1)\) stati ed esegue un numero costante di operazioni per ciascuno di essi. Il ciclo finale scorre una volta \(L_n\). Pertanto\[ S(n,P)=\Theta(nP). \] -
La matrice \({u}\) ha sempre \((n+1)(P+1)\) celle, la maggior parte delle quali uguali a \(+\infty\), mentre le liste contengono solo gli stati effettivamente raggiungibili. Sull'istanza del KP dell'Esempio 17.13 le liste contengono \(1\), \(2\), \(3\) e \(5\) stati, contro le \(44\) celle della matrice \({u}\).
-
La lista \(L_j\) soddisfa anche \(|L_j|\le 2^j\), poiché gli oggetti \(\{1,2,\dots,j\}\) hanno \(2^j\) sottoinsiemi. Pertanto
\[ |L_j|\le \min\big\{2^j,\,P+1\big\}. \]
Avanti: Errori tipici · In sintesi