Algoritmi ricorsivi
Parte 5 · Ricorsione · Capitolo 17 · Dispensa, volume 5 (PDF) · Esercizi: Algoritmi ricorsivi · App: Merge sort
Introduzione
Nei capitoli «Ricorsione», «Equazioni di ricorrenza» e «Il Master theorem» abbiamo imparato come viene eseguito un algoritmo ricorsivo, come se ne descrive il numero di passi con un'equazione di ricorrenza e come si risolve tale equazione. In questo capitolo mettiamo al lavoro questi strumenti su quattro problemi classici sugli array:
-
la somma degli elementi di un array, il problema più semplice possibile, su cui confrontiamo un algoritmo iterativo e due algoritmi ricorsivi;
-
l'ordinamento, con il Merge Sort, il primo algoritmo del corso che batte gli algoritmi di ordinamento \(\Theta(n^2)\);
-
la ricerca in un array ordinato, con la ricerca binaria ricorsiva;
-
il problema del sotto-array di somma massima, in cui un algoritmo divide et impera migliora la forza bruta, e un algoritmo iterativo ingegnoso migliora entrambi.
Tutti gli algoritmi sono studiati con lo stesso schema, che è lo schema dell'analisi di ogni algoritmo ricorsivo.
Per ogni algoritmo ricorsivo:
-
scriviamo lo pseudocodice e lo eseguiamo su un piccolo esempio, disegnando l'albero delle chiamate;
-
dimostriamo che è corretto, per induzione (forte) sulla dimensione del sottoproblema;
-
descriviamo il suo numero di passi con un'equazione di ricorrenza e la risolviamo, con l'albero di ricorsione e con il Master theorem;
-
esprimiamo il tempo di esecuzione nel caso peggiore in funzione della dimensione \(|I|\) dell'input;
-
misuriamo la memoria aggiuntiva, che per un algoritmo ricorsivo comprende la pila delle chiamate;
-
lo eseguiamo in Python,
C++e Java, nei notebook Colab del capitolo (array indicizzati da \(0\), mentre nello pseudocodice sono indicizzati da \(1\)).
Tre dei quattro algoritmi seguono il paradigma divide et impera: il problema su un sotto-array \(a[l..r]\) viene suddiviso in sottoproblemi sulle due metà \(a[l..m]\) e \(a[m+1..r]\) (divide), i sottoproblemi vengono risolti ricorsivamente (impera), e le loro soluzioni vengono messe insieme (combina). La ricerca binaria ricorsiva, invece, effettua una sola chiamata ricorsiva su una metà.
17.1 La somma degli elementi di un array
17.1.1 Il problema
Dato un array \(a[1..n]\) di \(n \ge 1\) numeri interi, consideriamo il problema di calcolare la somma dei suoi elementi:
-
Questo è uno dei problemi più semplici sugli array, ed è il problema ideale per confrontare un algoritmo iterativo e un algoritmo ricorsivo che risolvono lo stesso problema.
-
Scriviamo l'algoritmo ricorsivo, dimostriamo che è corretto, descriviamo il suo numero di passi con un'equazione di ricorrenza e risolviamo l'equazione, usando gli strumenti dei capitoli «Ricorsione», «Equazioni di ricorrenza» e «Il Master theorem».
Esempio 17.1: somma di un array
Consideriamo il seguente array di \(n=7\) numeri interi:
La somma dei suoi elementi è
17.1.2 Algoritmo iterativo
- Partiamo dall'ovvio algoritmo iterativo
SumIterative, che scorre l'array da sinistra a destra e accumula le somme parziali nella variabile \(s\):
Algoritmo: SumIterative
-
Sia \(S(n)\) il numero di passi eseguiti da
SumIterativesu un array di \(n\) elementi (non c'è differenza tra caso migliore e caso peggiore: l'algoritmo esegue sempre le stesse operazioni). Il numero di volte che ciascuna riga di codice viene eseguita è:-
La riga 2 viene eseguita \(1\) volta
-
La riga 3 viene eseguita \(1\) volta
-
La riga 4 viene eseguita \(n+1\) volte
-
La riga 5 viene eseguita \(n\) volte
-
La riga 6 viene eseguita \(n\) volte
-
La riga 8 viene eseguita \(1\) volta
Quindi,
\[ S(n) = 1+1+(n+1)+n+n+1 = 3n+4 = \Theta(n), \qquad\text{poiché}\qquad \lim_{n\to\infty}\frac{3n+4}{n}=\lim_{n\to\infty}\left(3+\frac{4}{n}\right)=3\in\R_{>0}. \] -
-
Oltre all'array in ingresso, l'algoritmo usa solo le due variabili \(s\) e \(i\): la memoria aggiuntiva è \(\Theta(1)\).
17.1.3 Algoritmo ricorsivo (divide et impera)
-
La stessa somma si può calcolare ricorsivamente. La somma degli elementi di un sotto-array \(a[l..r]\) si ottiene con il metodo divide et impera:
-
Divide: si suddivide \(a[l..r]\) nelle due metà \(a[l..m]\) e \(a[m+1..r]\), dove \(m=\lfloor (l+r)/2\rfloor\);
-
Impera: si calcolano ricorsivamente la somma \(s_1\) di \(a[l..m]\) e la somma \(s_2\) di \(a[m+1..r]\);
-
Combina: si restituisce \(s_1+s_2\).
-
-
Il caso base è un sotto-array con un solo elemento (\(l=r\)): la sua somma è l'elemento \(a[l]\) stesso.
-
Questo è lo pseudocodice dell'algoritmo ricorsivo
RecursiveSum. Per sommare l'intero array chiamiamoRecursiveSum\((a,1,n)\).
Algoritmo: RecursiveSum
-
Sia \(k = r-l+1\) il numero di elementi di \(a[l..r]\). Se \(k\ge 2\), le due metà hanno
\[ m-l+1 = \left\lceil \frac{k}{2}\right\rceil \qquad\text{e}\qquad r-m = \left\lfloor \frac{k}{2}\right\rfloor \]elementi, rispettivamente. Entrambi i numeri sono almeno \(1\) e strettamente minori di \(k\): ogni chiamata ricorsiva lavora su un sotto-array più piccolo, e la ricorsione raggiunge sempre il caso base.
17.1.4 Albero delle chiamate
- L'esecuzione di un algoritmo ricorsivo è rappresentata dal suo albero delle chiamate: ogni nodo è una chiamata, e i figli di un nodo sono le chiamate che esso effettua. Il valore restituito da una chiamata viene rimandato al padre.
Esempio 17.2: albero delle chiamate di RecursiveSum
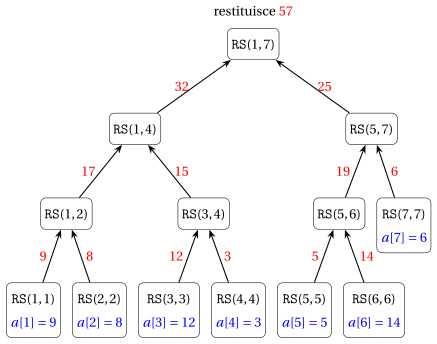
Consideriamo l'array dell'Esempio 17.1, cioè \(a=[9,8,12,3,5,14,6]\) e \(n=7\). Questo è l'albero delle chiamate di RecursiveSum\((a,1,7)\), in cui ogni nodo RS\((l,r)\) è una chiamata sul sotto-array \(a[l..r]\). In blu gli elementi dell'array restituiti dai casi base, in rosso i valori restituiti ai padri dalle chiamate (lungo le frecce):
-
La radice
RS\((1,7)\) calcola \(m=\lfloor 8/2\rfloor = 4\) e chiamaRS\((1,4)\) eRS\((5,7)\). -
RS\((1,4)\) calcola \(m=2\) e restituisce \(17+15=32\);RS\((5,7)\) calcola \(m=6\) e restituisce \(19+6=25\). -
La radice restituisce \(32+25=57\), che è la somma degli elementi dell'array.
-
Ci sono \(13 = 2\cdot 7-1\) chiamate: \(7\) foglie (casi base, una per ogni elemento) e \(6\) nodi interni, ciascuno dei quali esegue un'addizione, quindi in totale ci sono \(6=n-1\) addizioni.
-
Le chiamate vengono eseguite in ordine di visita in profondità: una chiamata termina solo dopo che sono terminati entrambi i suoi figli. Nell'esempio le chiamate terminano nell'ordine
\[ (1,1),\ (2,2),\ (1,2),\ (3,3),\ (4,4),\ (3,4),\ (1,4),\ (5,5),\ (6,6),\ (5,6),\ (7,7),\ (5,7),\ (1,7). \]
17.1.5 Correttezza
- La correttezza di un algoritmo ricorsivo si dimostra per induzione forte sulla dimensione del sottoproblema: si assume che le chiamate ricorsive, che lavorano su sotto-array più piccoli, siano corrette, e si mostra che la chiamata combina correttamente i loro risultati.
Osservazione 17.1: correttezza di RecursiveSum
Per ogni coppia di indici \(l \le r\), la chiamata RecursiveSum\((a,l,r)\) termina e restituisce
Dimostrazione
Usiamo l'induzione forte sul numero \(k=r-l+1 \ge 1\) di elementi del sotto-array.
Caso base (\(k=1\)). Allora \(l=r\), la condizione della riga 2 è vera e l'algoritmo restituisce \(a[l] = \sum_{i=l}^{l} a[i]\).
Passo induttivo (\(k \ge 2\)). Supponiamo che l'enunciato valga per tutti i sotto-array con meno di \(k\) elementi (ipotesi induttiva). Poiché \(l<r\), l'algoritmo calcola \(m=\lfloor (l+r)/2\rfloor\), con \(l \le m < r\). I sotto-array \(a[l..m]\) e \(a[m+1..r]\) hanno \(\lceil k/2\rceil\) e \(\lfloor k/2\rfloor\) elementi, entrambi compresi tra \(1\) e \(k-1\). Per l'ipotesi induttiva, le due chiamate ricorsive terminano e
Quindi, l'algoritmo restituisce
□
- Con \(l=1\) e \(r=n\), la chiamata
RecursiveSum\((a,1,n)\) restituisce la somma di tutti gli elementi dell'array.
17.1.6 Numero di passi di RecursiveSum
L'equazione di ricorrenza
-
Sia \(S(n)\) il numero di passi eseguiti da
RecursiveSumsu un sotto-array di \(n=r-l+1\) elementi. Come per l'algoritmo iterativo, il numero di passi dipende solo da \(n\) (e non dai valori degli elementi). -
Contiamo le righe di codice eseguite da una singola chiamata. Una riga che contiene una chiamata ricorsiva conta \(1\) passo (la chiamata stessa) più tutti i passi eseguiti dalla funzione chiamata, che esprimiamo ancora con \(S\).
-
Se \(n=1\), le righe 2 e 3 vengono eseguite \(1\) volta ciascuna, e quindi \(S(1)=2\).
-
If \(n\ge 2\):
-
La riga 2 viene eseguita \(1\) volta
-
La riga 3 non viene eseguita
-
La riga 5 viene eseguita \(1\) volta
-
La riga 6 viene eseguita \(1\) volta, più i \(S(\lceil n/2\rceil)\) passi della chiamata su \(a[l..m]\)
-
La riga 7 viene eseguita \(1\) volta, più i \(S(\lfloor n/2\rfloor)\) passi della chiamata su \(a[m+1..r]\)
-
La riga 8 viene eseguita \(1\) volta
e quindi \(S(n) = S(\lceil n/2\rceil)+S(\lfloor n/2\rfloor)+5\).
-
Il numero di passi di RecursiveSum è descritto dall'equazione di ricorrenza
con \(c=5\). Come di consueto, nell'analisi asintotica la scriviamo semplicemente come
Soluzione con l'albero di ricorsione
-
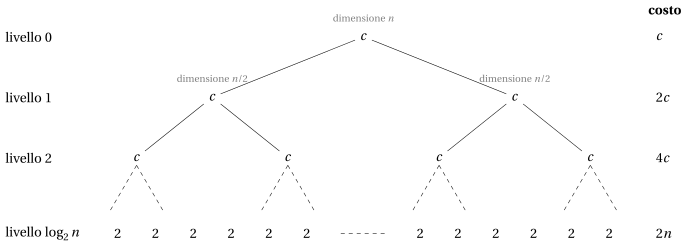
Nell'albero di ricorsione ogni nodo rappresenta una chiamata e contiene il numero di passi eseguiti da quella chiamata esclusi i passi delle sue chiamate ricorsive: \(c\) per un nodo interno, \(2\) per una foglia. \(S(n)\) è la somma dei valori di tutti i nodi.
-
Per semplicità, supponiamo dapprima che \(n=2^h\) sia una potenza esatta di \(2\). Allora ogni sotto-array viene suddiviso in due metà di uguale dimensione, e l'albero è:
-
Il livello \(i\) contiene \(2^i\) chiamate su sotto-array di \(n/2^i\) elementi. Le foglie sono al livello \(\log_2 n\), dove i sotto-array hanno \(n/2^{\log_2 n}=1\) elemento: ci sono \(2^{\log_2 n}=n\) foglie.
-
I livelli interni \(0,1,\dots,\log_2 n-1\) contengono
\[ \sum_{i=0}^{\log_2 n-1} 2^i = 2^{\log_2 n}-1 = n-1 \]nodi (somma di una serie geometrica). Quindi il numero totale di passi è
\[ S(n) = c\,(n-1) + 2n = 5(n-1)+2n = 7n-5. \] -
Il costo dei livelli raddoppia da un livello al successivo: il totale è dominato dalle foglie, che sono \(n\). Questa è esattamente la situazione del caso 1 del Master theorem.
-
Lo stesso conteggio vale per ogni \(n\), non solo per le potenze di \(2\): il fatto chiave è che l'albero ha esattamente \(n\) foglie e \(n-1\) nodi interni, come mostra la prossima osservazione.
Osservazione 17.2: chiamate e passi di RecursiveSum
Per ogni \(n\ge 1\), la chiamata RecursiveSum\((a,l,r)\) su un sotto-array di \(n=r-l+1\) elementi genera esattamente
chiamate (compresa la prima): \(n\) di esse sono casi base e \(n-1\) eseguono un'addizione. Inoltre, \(S(n)=7n-5\).
Dimostrazione
Sia \(C(n)\) il numero di chiamate. Abbiamo \(C(1)=1\) e, per \(n\ge 2\),
Dimostriamo che \(C(n)=2n-1\) per induzione forte su \(n\). Per \(n=1\): \(C(1)=1=2\cdot 1-1\). Per \(n \ge 2\), per l'ipotesi induttiva applicata a \(\lceil n/2\rceil<n\) e \(\lfloor n/2\rfloor<n\),
perché \(\lceil n/2\rceil+\lfloor n/2\rfloor=n\) per ogni numero naturale \(n\).
Ogni caso base corrisponde esattamente a un elemento del sotto-array (i sotto-array delle foglie sono disgiunti e ricoprono \(a[l..r]\)), quindi ci sono \(n\) casi base e \(2n-1-n=n-1\) chiamate che eseguono la riga 8.
Allo stesso modo, \(S(1)=2=7\cdot 1-5\) e, per \(n\ge 2\),
□
-
Di conseguenza,
\[ S(n)=7n-5=\Theta(n), \qquad\text{poiché}\qquad \lim_{n\to\infty}\frac{7n-5}{n}=7\in\R_{>0}. \]Per l'array dell'Esempio 17.2, \(S(7)=44\): \(7\) foglie con \(2\) passi ciascuna e \(6\) nodi interni con \(5\) passi ciascuno.
Soluzione con il Master theorem
- Possiamo ottenere l'ordine di crescita di \(S(n)\) direttamente dal Master theorem, senza calcolare \(S(n)\) esattamente. Ricordiamo il caso 1 del Master theorem:
Sia \(S(n)=a\,S(n/b)+f(n)\), con \(a\ge 1\) e \(b>1\) costanti e \(f(n)\) asintoticamente positiva. Se \(f(n)=O\big(n^{\log_b a-\varepsilon}\big)\) per una qualche costante \(\varepsilon>0\), allora
-
\(S(n)=2\,S(n/2)+c\) \(\quad\rightarrow\quad\) \(a=2\), \(b=2\), \(f(n)=c\).
-
\(n^{\log_b a}=n^{\log_2 2}=n^1=n\).
-
Confronto: \(f(n)=c\) cresce polinomialmente più lentamente di \(n\) \(\quad\rightarrow\quad\) caso 1.
-
Ipotesi: \(f(n)=c=O\big(n^{1-\varepsilon}\big)\) con \(\varepsilon=1\), poiché \(c = c\cdot n^{0}\).
-
Conclusione: \(S(n)=\Theta\big(n^{\log_2 2}\big)=\Theta(n)\).
Come previsto, il risultato è in accordo con la soluzione esatta \(S(n)=7n-5\).
Tempo di esecuzione nel caso peggiore
-
Come nel capitolo «Tempo di esecuzione», facciamo l'ipotesi che ogni elemento dell'array sia memorizzato usando un numero costante fissato di bit. Allora \(|I|=\Theta(n)\), cioè esistono costanti \(c_1,c_2>0\) tali che \(c_1 n\le |I| \le c_2 n\) per ogni \(n\) sufficientemente grande, e
\[ \frac{1}{c_2}|I| \le n \le \frac{1}{c_1}|I|. \]Poiché \(S(n)=7n-5=\Theta(n)\), esistono costanti \(a_1,a_2>0\) tali che \(a_1 n\le S(n) \le a_2 n\) per ogni \(n\) sufficientemente grande, e quindi
\[ \frac{a_1}{c_2}|I| \le S(n) \le \frac{a_2}{c_1}|I|. \]
Se tutti i valori in ingresso usano un numero costante fissato di bit, allora il tempo di esecuzione nel caso peggiore dell'algoritmo RecursiveSum (e anche dell'algoritmo SumIterative) è
Quindi, entrambi gli algoritmi sono lineari nella dimensione dell'input.
- La ricorsione non rende l'algoritmo più veloce: entrambi gli algoritmi leggono ogni elemento una volta ed eseguono \(n-1\) (ricorsivo) oppure \(n\) (iterativo) addizioni. La versione ricorsiva esegue anzi più passi (\(7n-5\) contro \(3n+4\)), a causa del sovraccarico delle chiamate.
17.1.7 Memoria aggiuntiva: la pila delle chiamate
-
Il tempo non è l'unica risorsa. Ogni chiamata attiva di una funzione ricorsiva richiede un proprio record di attivazione nella pila delle chiamate (call stack), che contiene i suoi parametri, le sue variabili locali e l'indirizzo di ritorno. In
RecursiveSumi parametri e le variabili locali sono \(l\), \(r\), \(m\), \(s_1\), \(s_2\): ogni record di attivazione ha dimensione costante. -
Una chiamata è attiva dal momento in cui inizia fino a quando termina. Poiché le chiamate vengono eseguite in profondità, le chiamate attive in ogni istante formano un cammino dalla radice dell'albero delle chiamate al nodo corrente. Quindi:
Il massimo numero di chiamate contemporaneamente attive (la profondità della ricorsione) è uguale all'altezza dell'albero delle chiamate più uno. La memoria aggiuntiva usata da un algoritmo ricorsivo è (almeno) proporzionale alla profondità della ricorsione.
Osservazione 17.3: profondità della ricorsione di RecursiveSum
Per ogni \(n\ge 1\), l'albero delle chiamate di RecursiveSum su un sotto-array di \(n\) elementi ha altezza \(\lceil \log_2 n\rceil\). Quindi la profondità della ricorsione è \(\lceil \log_2 n\rceil+1\) e la memoria aggiuntiva usata da RecursiveSum è \(\Theta(\log_2 n)\).
Dimostrazione
Sia \(h(n)\) l'altezza dell'albero delle chiamate. Allora \(h(1)=0\) e, per \(n\ge 2\),
Dimostriamo che \(h(n)=\lceil \log_2 n\rceil\) per induzione forte. Per \(n=1\), \(\lceil \log_2 1\rceil = 0\). Sia \(n\ge 2\). Poiché \(\lceil \log_2 x\rceil\) è non decrescente in \(x\), per l'ipotesi induttiva il massimo è raggiunto dalla metà più grande, e \(h(n)=1+\lceil \log_2 \lceil n/2\rceil\rceil\).
Sia \(k=\lceil \log_2 n\rceil\ge 1\), cioè \(2^{k-1}<n\le 2^k\). Dividendo per \(2\), otteniamo \(2^{k-2}<n/2\le 2^{k-1}\); poiché \(2^{k-1}\) è un intero, anche \(2^{k-2}<\lceil n/2\rceil\le 2^{k-1}\), cioè \(\lceil \log_2\lceil n/2\rceil\rceil=k-1\). Quindi \(h(n)=1+(k-1)=k=\lceil \log_2 n\rceil\).
Ogni record di attivazione ha dimensione costante, quindi la memoria aggiuntiva è \(\Theta(\lceil \log_2 n\rceil+1)=\Theta(\log_2 n)\). □
- Nell'Esempio 17.2, \(n=7\) e la profondità della ricorsione è \(\lceil \log_2 7\rceil+1=3+1=4\): per esempio, quando viene eseguita
RS\((1,1)\), le chiamate attive sonoRS\((1,7)\),RS\((1,4)\),RS\((1,2)\) eRS\((1,1)\).
| algoritmo | numero di passi | memoria aggiuntiva |
|---|---|---|
SumIterative |
\(3n+4=\Theta(n)\) | \(\Theta(1)\) |
RecursiveSum |
\(7n-5=\Theta(n)\) | \(\Theta(\log_2 n)\) |
17.1.8 Una ricorsione diversa: decremento di uno
- Dimezzare non è l'unico modo di sommare un array ricorsivamente. L'array può anche essere suddiviso in modo sbilanciato: la somma di \(a[1..n]\) è la somma di \(a[1..n-1]\) più \(a[n]\). Questa è una ricorsione per decremento di uno:
Algoritmo: RecursiveSumLinear
-
La correttezza segue per induzione (semplice) su \(n\): per \(n=1\) l'algoritmo restituisce \(a[1]\); per \(n\ge 2\), per l'ipotesi induttiva \(s=a[1]+\cdots+a[n-1]\), e l'algoritmo restituisce \(s+a[n]=a[1]+\cdots+a[n]\).
-
Se \(n=1\), le righe 2 e 3 vengono eseguite una volta: \(S(1)=2\). Se \(n\ge 2\), le righe 2, 5 e 6 vengono eseguite una volta, più i \(S(n-1)\) passi della chiamata ricorsiva:
\[ S(n)= \begin{cases} 2 & \text{se } n=1,\\ S(n-1)+3 & \text{se } n\ge 2. \end{cases} \] -
Il Master theorem non si può applicare, perché la dimensione del sottoproblema è \(n-1\) e non \(n/b\) per una costante \(b>1\). Risolviamo l'equazione per iterazione (srotolamento):
\[ S(n) = S(n-1)+3 = S(n-2)+2\cdot 3 = \cdots = S(1)+(n-1)\cdot 3 = 3n-1 = \Theta(n). \] -
L'albero delle chiamate è un cammino di \(n\) nodi:
RecursiveSumLinear\((a,n)\) chiamaRecursiveSumLinear\((a,n-1)\), che chiamaRecursiveSumLinear\((a,n-2)\), e così via, fino a \(n=1\). Quando si raggiunge il caso base, tutte le \(n\) chiamate sono attive.
RecursiveSumLinear esegue \(S(n)=3n-1=\Theta(n)\) passi, ma la sua profondità di ricorsione è \(n\): richiede \(\Theta(n)\) di memoria aggiuntiva per la pila delle chiamate (contro \(\Theta(\log_2 n)\) di RecursiveSum e \(\Theta(1)\) di SumIterative). In pratica, per \(n\) grande (ad esempio \(n=10^7\)) la versione per decremento di uno può esaurire la pila delle chiamate (stack overflow), mentre RecursiveSum richiede solo \(\lceil\log_2 10^7\rceil+1=25\) chiamate attive.
Punti chiave sulla somma di un array.
-
RecursiveSumè corretto (induzione forte), effettua \(2n-1\) chiamate ed esegue \(7n-5=\Theta(n)\) passi: la ricorsione non riduce il lavoro, che è lineare perché ogni elemento deve essere letto. -
L'equazione di ricorrenza \(S(n)=2S(n/2)+c\) ricade nel caso 1 del Master theorem: il costo è dominato dalle \(n\) foglie.
-
La pila delle chiamate costa memoria: \(\Theta(\log_2 n)\) per la ricorsione per dimezzamento, \(\Theta(n)\) per la ricorsione per decremento di uno, \(\Theta(1)\) per il ciclo.
17.2 Merge Sort
Per la somma di un array, il divide et impera non ha dato alcun guadagno in termini di tempo. Incontriamo ora un problema in cui fa la differenza: l'ordinamento.
17.2.1 Il problema dell'ordinamento
Dato un array \(a[1..n]\) di \(n\) numeri naturali, consideriamo il problema di riordinare gli elementi dell'array in ordine non decrescente in modo che:
-
Il problema è stato introdotto nel capitolo «Algoritmi di ordinamento», dove abbiamo studiato Insertion Sort, Exchange Sort e Selection Sort. Nel capitolo «Tempo di esecuzione» abbiamo dimostrato che il numero di passi di
InsertionSortnel caso peggiore è \(S(n)=\frac{3n^2+9n-8}{2}=\Theta(n^2)\). -
In questa sezione studiamo il Merge Sort, un algoritmo di ordinamento ricorsivo basato sui confronti e sul paradigma divide et impera, il cui numero di passi è \(\Theta(n\log_2 n)\) nel caso peggiore.
Esempio 17.4: un'istanza di ordinamento
Consideriamo il seguente array di \(n=7\) numeri naturali:
L'array ordinato è:
17.2.2 L'algoritmo Merge Sort
Divide et impera
-
Il Merge Sort ordina un sotto-array \(a[l..r]\) come segue:
-
Divide: si suddivide \(a[l..r]\) nelle due metà \(a[l..m]\) e \(a[m+1..r]\), dove \(m=\lfloor (l+r)/2\rfloor\);
-
Impera: si ordinano ricorsivamente le due metà;
-
Combina: si fondono (merge) le due metà ordinate in un unico sotto-array ordinato \(a[l..r]\).
-
-
Il caso base è un sotto-array con un solo elemento (\(l=r\)), che è già ordinato: non occorre fare nulla.
-
Tutto il lavoro è svolto nel passo combina, dalla procedura
Merge. L'osservazione chiave è che due sequenze ordinate si possono fondere in modo molto efficiente: il più piccolo elemento del risultato è il minore tra i due primi elementi, e così via.
Pseudocodice
- Questo è lo pseudocodice dell'algoritmo
MergeSort. Per ordinare l'intero array \(a[1..n]\), chiamiamoMergeSort\((a,1,n)\).
Algoritmo: MergeSort
-
Se \(k=r-l+1\ge 2\), le due metà \(a[l..m]\) e \(a[m+1..r]\) hanno \(\lceil k/2\rceil\) e \(\lfloor k/2\rfloor\) elementi, entrambi compresi tra \(1\) e \(k-1\): la ricorsione raggiunge sempre il caso base.
-
La procedura
Merge\((a,l,m,r)\) suppone che \(a[l..m]\) e \(a[m+1..r]\) siano ordinati. Li copia in due array ausiliari \(L\) e \(R\), e poi sposta ripetutamente in \(a\) il minore tra i primi due elementi non ancora copiati:
Algoritmo: Merge
-
Spiegazione di
Merge:-
Le righe 2–9 copiano \(a[l..m]\) in \(L[1..n_1]\) e \(a[m+1..r]\) in \(R[1..n_2]\). Le copie sono necessarie, perché le posizioni \(a[l..r]\) vengono sovrascritte durante la fusione.
-
Gli indici \(i\) e \(j\) puntano ai primi elementi di \(L\) e \(R\) non ancora ricopiati, e \(k\) punta alla prossima posizione di \(a\) da riempire.
-
Il primo ciclo while (riga 14) confronta \(L[i]\) e \(R[j]\) e copia il minore in \(a[k]\) (in caso di parità, viene copiato per primo l'elemento di \(L\): questo rende il Merge Sort stabile).
-
Non appena uno dei due array si esaurisce, gli elementi rimanenti dell'altro (che sono già ordinati, e non più piccoli di quelli già copiati) vengono copiati in \(a\) dal ciclo while della riga 26 o da quello della riga 29. Solo uno di questi due cicli esegue almeno un'iterazione.
-
Esempi
Eseguiamo ora il Merge Sort sull'array dell'Esempio 17.4: guardiamo prima l'intero albero delle chiamate, poi le due fasi dell'algoritmo, e infine una singola chiamata di Merge.
Esempio 17.5: albero delle chiamate di MergeSort
Consideriamo l'array dell'Esempio 17.4, cioè \(a=[9,12,3,16,19,11,12]\). Questo è l'albero delle chiamate di MergeSort\((a,1,7)\), in cui ogni nodo MS\((l,r)\) è una chiamata sul sotto-array \(a[l..r]\). In ogni nodo, in blu il sotto-array ricevuto dalla chiamata e in rosso il sotto-array ordinato prodotto dalla chiamata (dopo la sua Merge):
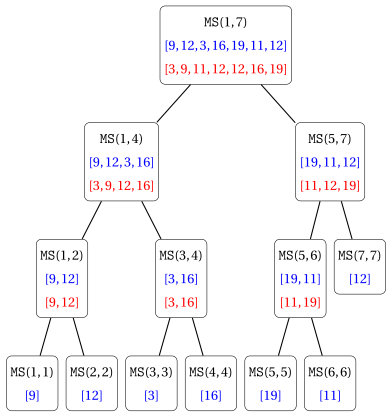
Le chiamate di Merge vengono eseguite nel seguente ordine (in profondità), e questo è il contenuto dell'array dopo ciascuna di esse (il sotto-array modificato da ciascuna chiamata è in rosso):
| chiamata | sotto-array fusi | array \(a\) dopo la chiamata |
|---|---|---|
Merge\((a,1,1,2)\) |
\([9]\) e \([12]\) | \([\red{9,12},3,16,19,11,12]\) |
Merge\((a,3,3,4)\) |
\([3]\) e \([16]\) | \([9,12,\red{3,16},19,11,12]\) |
Merge\((a,1,2,4)\) |
\([9,12]\) e \([3,16]\) | \([\red{3,9,12,16},19,11,12]\) |
Merge\((a,5,5,6)\) |
\([19]\) e \([11]\) | \([3,9,12,16,\red{11,19},12]\) |
Merge\((a,5,6,7)\) |
\([11,19]\) e \([12]\) | \([3,9,12,16,\red{11,12,19}]\) |
Merge\((a,1,4,7)\) |
\([3,9,12,16]\) e \([11,12,19]\) | \([\red{3,9,11,12,12,16,19}]\) |
Esempio 17.6: fasi di divisione e di combinazione di MergeSort
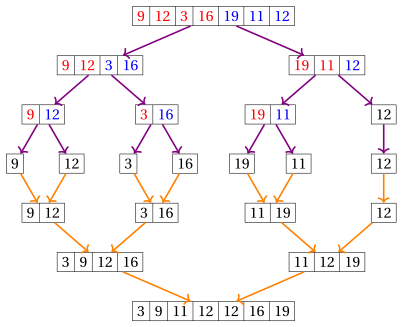
Consideriamo di nuovo l'array dell'Esempio 17.4. La parte superiore della figura mostra la fase di divisione (frecce viola): ogni sotto-array viene suddiviso nella sua metà sinistra (in rosso) e nella sua metà destra (in blu), fino a ottenere sotto-array di un elemento. La parte inferiore mostra la fase di combinazione (frecce arancioni): coppie di sotto-array ordinati vengono fuse in un sotto-array ordinato.
Esempio 17.7: traccia di Merge
Consideriamo l'ultima chiamata Merge\((a,1,4,7)\) dell'Esempio 17.5. Prima della chiamata \(a=[3,9,12,16,11,12,19]\), con \(a[1..4]\) e \(a[5..7]\) ordinati. Allora \(n_1=4\), \(n_2=3\) e
Questa è l'esecuzione dei cicli while (una riga per ogni elemento copiato in \(a\)):
| \(k\) | \(i\) | \(j\) | \(L[i]\) | \(R[j]\) | confronto | azione |
|---|---|---|---|---|---|---|
| 1 | 1 | 1 | 3 | 11 | \(3 \le 11\) | \(a[1]\leftarrow 3\), \(i=2\) |
| 2 | 2 | 1 | 9 | 11 | \(9 \le 11\) | \(a[2]\leftarrow 9\), \(i=3\) |
| 3 | 3 | 1 | 12 | 11 | \(12 > 11\) | \(a[3]\leftarrow 11\), \(j=2\) |
| 4 | 3 | 2 | 12 | 12 | \(12 \le 12\) | \(a[4]\leftarrow 12\) (da \(L\)), \(i=4\) |
| 5 | 4 | 2 | 16 | 12 | \(16 > 12\) | \(a[5]\leftarrow 12\) (da \(R\)), \(j=3\) |
| 6 | 4 | 3 | 16 | 19 | \(16 \le 19\) | \(a[6]\leftarrow 16\), \(i=5\) |
| 7 | 5 | 3 | – | 19 | \(L\) esaurito | \(a[7]\leftarrow 19\), \(j=4\) |
Dopo \(6\) iterazioni del primo ciclo while (e \(6\) confronti), \(i=5>n_1\): l'array \(L\) è esaurito, e l'ultimo elemento di \(R\) viene copiato dal ciclo while della riga 29. Il risultato è \(a=[3,9,11,12,12,16,19]\).
17.2.3 Correttezza
La correttezza del Merge Sort poggia su due fatti: Merge fonde correttamente due sotto-array ordinati (una proprietà di un ciclo, dimostrata con un'invariante di ciclo), e la ricorsione è corretta (dimostrata per induzione forte, come per RecursiveSum).
Correttezza di Merge
- Dimostriamo la correttezza di
Mergecon un'invariante di ciclo, cioè una proprietà che vale all'inizio di ogni iterazione di un ciclo. Come nel capitolo «Correttezza», mostriamo che l'invariante vale prima della prima iterazione (inizializzazione), che se vale prima di un'iterazione vale anche prima della successiva (mantenimento), e che cosa ci fornisce quando il ciclo termina (terminazione).
Osservazione 17.4: invariante di ciclo di Merge
Siano \(a[l..m]\) e \(a[m+1..r]\) ordinati. All'inizio di ogni iterazione del ciclo while della riga 14 di Merge:
-
(I1) il sotto-array \(a[l..k-1]\) contiene i \(k-l\) elementi di \(L[1..i-1]\) e \(R[1..j-1]\), in ordine non decrescente;
-
(I2) ogni elemento di \(a[l..k-1]\) è minore o uguale a ogni elemento di \(L[i..n_1]\) e di \(R[j..n_2]\).
Alla fine, Merge termina e \(a[l..r]\) contiene gli elementi originariamente in \(a[l..r]\), ordinati in ordine non decrescente.
Dimostrazione
Dopo le righe 2–9, \(L[1..n_1]\) e \(R[1..n_2]\) sono copie dei sotto-array ordinati \(a[l..m]\) e \(a[m+1..r]\), quindi sono ordinati.
Inizializzazione. Prima della prima iterazione \(k=l\), \(i=1\), \(j=1\): il sotto-array \(a[l..k-1]\) è vuoto, e (I1) e (I2) valgono banalmente.
Mantenimento. Supponiamo (I1) e (I2) all'inizio di un'iterazione, e sia \(L[i]\le R[j]\) (l'altro caso è simmetrico). Poiché \(L\) e \(R\) sono ordinati, \(L[i]\le L[i+1..n_1]\) e \(L[i]\le R[j]\le R[j+1..n_2]\): \(L[i]\) è il più piccolo elemento non ancora copiato. Per (I2), \(L[i]\) è maggiore o uguale a tutti gli elementi di \(a[l..k-1]\), quindi dopo \(a[k]\leftarrow L[i]\) il sotto-array \(a[l..k]\) è ordinato e contiene \(L[1..i]\) e \(R[1..j-1]\). Dopo \(i\leftarrow i+1\) e \(k\leftarrow k+1\), (I1) vale di nuovo. Vale anche (I2), perché gli elementi non ancora copiati sono un sottoinsieme dei precedenti, e il nuovo elemento \(a[k-1]=L[i-1]\) è minore o uguale a tutti loro.
Terminazione. Ogni iterazione aumenta \(i+j\) di uno, quindi il ciclo termina dopo al più \(n_1+n_2\) iterazioni, con \(i=n_1+1\) oppure \(j=n_2+1\). Supponiamo \(i=n_1+1\) (l'altro caso è simmetrico). Il ciclo della riga 26 viene saltato, e il ciclo della riga 29 copia \(R[j..n_2]\), in questo ordine, in \(a[k..r]\). Poiché \(R[j..n_2]\) è ordinato e, per (I2), i suoi elementi non sono più piccoli di quelli di \(a[l..k-1]\), l'intero sotto-array \(a[l..r]\) è ordinato. Per (I1), contiene esattamente gli elementi di \(L\) e \(R\), cioè gli elementi originariamente in \(a[l..r]\). □
Correttezza di MergeSort
Osservazione 17.5: correttezza di MergeSort
Per ogni coppia di indici \(l\le r\), la chiamata MergeSort\((a,l,r)\) termina e riordina gli elementi di \(a[l..r]\) in ordine non decrescente (senza modificare il resto dell'array).
Dimostrazione
Usiamo l'induzione forte sul numero \(k=r-l+1\ge 1\) di elementi del sotto-array.
Caso base (\(k=1\)). Allora \(l=r\), la condizione della riga 2 è falsa e non si fa nulla: un sotto-array di un elemento è ordinato.
Passo induttivo (\(k\ge 2\)). Supponiamo che l'enunciato valga per tutti i sotto-array con meno di \(k\) elementi. Poiché \(l<r\), l'algoritmo calcola \(m=\lfloor (l+r)/2\rfloor\), con \(l\le m<r\). I sotto-array \(a[l..m]\) e \(a[m+1..r]\) hanno \(\lceil k/2\rceil\) e \(\lfloor k/2\rfloor\) elementi, entrambi compresi tra \(1\) e \(k-1\). Per l'ipotesi induttiva, dopo le righe 4 e 5 sia \(a[l..m]\) sia \(a[m+1..r]\) sono ordinati (e contengono gli stessi elementi di prima). Quindi l'ipotesi di Merge è soddisfatta, e per l'Osservazione 17.4, dopo la riga 6 il sotto-array \(a[l..r]\) è ordinato. □
17.2.4 Numero di passi
Numero di passi di Merge
-
Sia \(n=r-l+1=n_1+n_2\) il numero di elementi da fondere, e sia \(t\) il numero di iterazioni del ciclo while della riga 14. Tra queste, \(t_L\) copiano un elemento di \(L\) e \(t_R\) copiano un elemento di \(R\), con \(t_L+t_R=t\). L'intestazione di un ciclo for da \(1\) a \(n_1\) viene eseguita \(n_1+1\) volte (l'ultimo test fallisce). La riga
elsefa parte dell'ifdella riga 15 e non viene contata separatamente.Il numero di volte che ciascuna riga di codice viene eseguita è:
-
La riga 5 viene eseguita \(n_1+1\) volte e la riga 6 \(n_1\) volte
-
La riga 8 viene eseguita \(n_2+1\) volte e la riga 9 \(n_2\) volte
-
La riga 14 viene eseguita \(t+1\) volte
-
La riga 15 viene eseguita \(t\) volte
-
La riga 22 viene eseguita \(t\) volte
-
La riga 26 viene eseguita \((n_1-t_L)+1\) volte e le righe 26, 26, 26 \(n_1-t_L\) volte ciascuna
-
La riga 29 viene eseguita \((n_2-t_R)+1\) volte e le righe 29, 29, 29 \(n_2-t_R\) volte ciascuna
Quindi, il numero totale di passi di
Mergeè\[\begin{align*} & 3 + (2n_1+1) + (2n_2+1) + 3 + (t+1) + t + 2t_L + 2t_R + t + 4(n_1-t_L)+1 + 4(n_2-t_R)+1 \\[1ex] &= 11 + 2n + 5t + 4(n-t) = 6n + t + 11. \end{align*}\] -
Ogni iterazione del primo ciclo while copia un elemento in \(a\), quindi \(t\le n\). Più precisamente:
-
il ciclo si ferma non appena uno dei due array si esaurisce, quindi \(t\ge \min\{n_1,n_2\}\);
-
quando il ciclo si ferma, l'altro array contiene ancora almeno un elemento, quindi \(t\le n-1\).
Quindi il numero di passi di
Mergesu \(n\) elementi è compreso tra \(6n+11+\min\{n_1,n_2\}\) e \(7n+10\); in particolare, è compreso tra \(6n+11\) e \(7n+10\). Il caso peggiore \(t=n-1\) si verifica, per esempio, nell'Esempio 17.7 (\(n=7\), \(t=6\), \(6\cdot 7+6+11=59\) passi). -
Il numero di passi di Merge su \(n=r-l+1\) elementi è \(6n+t+11\) e soddisfa
Il numero di confronti tra elementi (riga 15) è \(t\), con \(\min\{n_1,n_2\}\le t\le n-1\).
L'equazione di ricorrenza di MergeSort
-
Sia \(S(n)\) il numero di passi eseguiti da
MergeSortnel caso peggiore su un sotto-array di \(n=r-l+1\) elementi. Come per la somma di un array, una riga che contiene una chiamata conta \(1\) passo più i passi della funzione chiamata. -
Se \(n=1\), viene eseguita solo la riga 2: \(S(1)=1\).
-
If \(n\ge 2\):
-
La riga 2 viene eseguita \(1\) volta
-
La riga 3 viene eseguita \(1\) volta
-
La riga 4 viene eseguita \(1\) volta, più i \(S(\lceil n/2\rceil)\) passi della chiamata
-
La riga 5 viene eseguita \(1\) volta, più i \(S(\lfloor n/2\rfloor)\) passi della chiamata
-
La riga 6 viene eseguita \(1\) volta, più i \(S_{\texttt{Merge}}(n)\) passi di
Merge
e quindi
\[ S(n)=S(\lceil n/2\rceil)+S(\lfloor n/2\rfloor)+f(n), \qquad f(n)=5+S_{\texttt{Merge}}(n). \] -
-
Dall'analisi di
Merge, \(6n+16\le f(n)\le 7n+15\). Poiché \(7n+15\le 15n\) per \(n\ge 2\), abbiamo\[ 6n \le f(n) \le 15\,n \qquad \text{per ogni } n\ge 2, \qquad\text{cioè}\qquad f(n)=\Theta(n). \]
Il numero di passi di MergeSort è descritto dall'equazione di ricorrenza
che, ignorando le parti intere inferiori e superiori, scriviamo come
Soluzione con l'albero di ricorsione
-
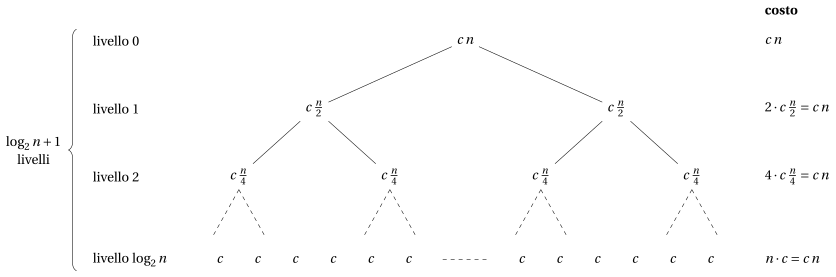
Supponiamo che \(n=2^h\) sia una potenza esatta di \(2\), e sia \(c=15\) la costante tale che \(f(n)\le c\,n\) (con \(S(1)=1\le c\)). Limitiamo dapprima \(S(n)\) dall'alto con l'albero di ricorsione di
\[ S(n)\le 2\,S(n/2)+c\,n, \]dove ogni nodo contiene il costo di una chiamata, escluso il costo delle sue chiamate ricorsive:
-
Il livello superiore ha costo \(c\,n\); il livello successivo ha costo \(c\frac{n}{2}+c\frac{n}{2}=c\,n\); quello dopo ha costo \(4\cdot c\frac{n}{4}=c\,n\), e così via. In generale, il livello \(i\) ha \(2^i\) nodi, ciascuno corrispondente a un sotto-array di \(n/2^i\) elementi e con un contributo di costo al più \(c\,n/2^i\), quindi ogni livello costa al più
\[ 2^i\cdot c\,\frac{n}{2^i} = c\,n. \] -
Il livello più basso \(\log_2 n\) ha \(n\) foglie (sotto-array di un elemento), ciascuna con costo \(S(1)=1\le c\): il suo costo è al più \(c\,n\).
-
I livelli sono \(0,1,\dots,\log_2 n\), cioè \(\log_2 n+1\). Sommando i costi di tutti i livelli:
\[ S(n)\le c\,n\,(\log_2 n+1) = c\,n\log_2 n + c\,n . \] -
Allo stesso modo, usando \(f(n)\ge 6n\), ogni livello interno costa almeno \(6n\), e ci sono \(\log_2 n\) livelli interni: \(S(n)\ge 6\,n\log_2 n\).
-
Quindi, per \(n\) potenza di \(2\),
\[ 6\,n\log_2 n \;\le\; S(n) \;\le\; 15\,n\log_2 n+15\,n, \qquad\text{cioè}\qquad S(n)=\Theta(n\log_2 n), \]poiché
\[ \lim_{n\to\infty}\frac{15\,n\log_2 n+15\,n}{n\log_2 n}=\lim_{n\to\infty}\left(15+\frac{15}{\log_2 n}\right)=15\in\R_{>0}. \] -
A differenza dell'albero di ricorsione della somma di un array, in cui il costo dei livelli raddoppia a ogni livello, qui tutti i livelli hanno lo stesso costo \(c\,n\): il totale è il costo di un livello per il numero di livelli. Questa è esattamente la situazione del caso 2 del Master theorem.
Soluzione con il Master theorem
- Ricordiamo il caso 2 del Master theorem:
Sia \(S(n)=a\,S(n/b)+f(n)\), con \(a\ge 1\) e \(b>1\) costanti e \(f(n)\) asintoticamente positiva. Se \(f(n)=\Theta\big(n^{\log_b a}\log^k n\big)\) per una qualche costante \(k\ge 0\), allora
-
\(S(n)=2\,S(n/2)+\Theta(n)\) \(\quad\rightarrow\quad\) \(a=2\), \(b=2\), \(f(n)=\Theta(n)\).
-
\(n^{\log_b a}=n^{\log_2 2}=n\).
-
Confronto: \(f(n)\) e \(n^{\log_b a}\) crescono allo stesso modo \(\quad\rightarrow\quad\) caso 2.
-
Ipotesi: \(f(n)=\Theta(n)=\Theta\big(n^{\log_2 2}\log^0 n\big)\) con \(k=0\).
-
Conclusione: \(S(n)=\Theta\big(n^{\log_2 2}\log^{1} n\big)=\Theta(n\log n)\).
La base del logaritmo è irrilevante all'interno di \(\Theta\), perché \(\log_b n=\frac{\log_2 n}{\log_2 b}\) differisce da \(\log_2 n\) per un fattore costante. Quindi \(S(n)=\Theta(n\log_2 n)\), in accordo con l'albero di ricorsione.
Tempo di esecuzione nel caso peggiore
-
Facciamo l'ipotesi che ogni elemento dell'array sia memorizzato usando un numero costante fissato di bit. Allora \(|I|=\Theta(n)\): esistono costanti \(c_1,c_2>0\) tali che, per ogni \(n\) sufficientemente grande,
\[ \frac{1}{c_2}|I| \le n \le \frac{1}{c_1}|I|. \]Passando ai logaritmi, \(\log_2|I|-\log_2 c_2\le \log_2 n\le \log_2|I|-\log_2 c_1\), quindi, per \(|I|\) sufficientemente grande,
\[ \frac{1}{2}\log_2|I| \le \log_2 n \le 2\log_2|I|. \]Moltiplicando le due catene di disuguaglianze (tutti i termini sono positivi),
\[ \frac{1}{2c_2}\,|I|\log_2|I| \;\le\; n\log_2 n \;\le\; \frac{2}{c_1}\,|I|\log_2|I|, \]cioè \(n\log_2 n=\Theta(|I|\log_2|I|)\). Poiché \(S(n)=\Theta(n\log_2 n)\), otteniamo \(S(n)=\Theta(|I|\log_2|I|)\).
Se tutti i valori in ingresso usano un numero costante fissato di bit, allora il tempo di esecuzione nel caso peggiore dell'algoritmo MergeSort è
17.2.5 Memoria aggiuntiva
-
Merge\((a,l,m,r)\) alloca gli array ausiliari \(L\) e \(R\), con \(n_1+n_2=r-l+1\) elementi in totale, che vengono rilasciati quandoMergetermina. -
Mergeviene chiamata solo dopo che entrambe le chiamate ricorsive sono terminate, quindi in ogni istante è attiva al più unaMerge, e gli array ausiliari più grandi sono quelli della prima chiamataMergeSort\((a,1,n)\), con \(n\) elementi in totale. -
Inoltre, la pila delle chiamate contiene al più \(\lceil\log_2 n\rceil+1\) record di attivazione di dimensione costante (l'albero delle chiamate ha la stessa forma di quello di
RecursiveSum, Osservazione 17.3): memoria \(\Theta(\log_2 n)\).
MergeSort usa \(\Theta(n)+\Theta(\log_2 n)=\Theta(n)\) di memoria aggiuntiva: non è un algoritmo di ordinamento in place. Al contrario, InsertionSort ordina sul posto, con \(\Theta(1)\) di memoria aggiuntiva.
17.2.6 Confronto con Insertion Sort
-
Nel caso peggiore,
InsertionSortesegue \(\Theta(n^2)\) passi, mentreMergeSortesegue \(\Theta(n\log_2 n)\) passi. Poiché\[ \lim_{n\to\infty}\frac{n\log_2 n}{n^2}=\lim_{n\to\infty}\frac{\log_2 n}{n}=0, \]il Merge Sort è asintoticamente molto più veloce.
-
Per farsi un'idea della differenza, ignoriamo le costanti moltiplicative e supponiamo che un calcolatore esegua \(10^9\) passi al secondo:
| \(n\) | \(n^2\) | \(n\log_2 n\) | tempo per \(n^2\) passi | tempo per \(n\log_2 n\) passi |
|---|---|---|---|---|
| \(10\) | \(100\) | \(\approx 33\) | \(10^{-7}\) s | \(\approx 3.3\cdot 10^{-8}\) s |
| \(10^3\) | \(10^6\) | \(\approx 9\,966\) | \(10^{-3}\) s | \(\approx 10^{-5}\) s |
| \(10^6\) | \(10^{12}\) | \(\approx 1.99\cdot 10^{7}\) | \(10^{3}\) s \(\approx 16.7\) min | \(\approx 0.02\) s |
- Per array piccoli la differenza è trascurabile (e, a causa delle costanti e del costo delle chiamate ricorsive,
InsertionSortpuò anche essere più veloce). Per array grandi, il Merge Sort è enormemente più veloce: con \(n=10^6\) elementi è circa \(50\,000\) volte più veloce.
Punti chiave sul Merge Sort.
-
Tutto il lavoro è svolto da
Merge, che fonde due sotto-array ordinati di dimensione totale \(n\) in \(6n+t+11=\Theta(n)\) passi. -
L'equazione di ricorrenza \(S(n)=2S(n/2)+\Theta(n)\) ricade nel caso 2 del Master theorem: \(\log_2 n+1\) livelli di costo \(\Theta(n)\) ciascuno, \(S(n)=\Theta(n\log_2 n)\).
-
Il prezzo è la memoria: \(\Theta(n)\) per gli array ausiliari.
| algoritmo | numero di passi nel caso peggiore | memoria aggiuntiva |
|---|---|---|
InsertionSort |
\(\Theta(n^2)\) | \(\Theta(1)\) |
MergeSort |
\(\Theta(n\log_2 n)\) | \(\Theta(n)\) |
17.3 Ricerca binaria ricorsiva
Il Merge Sort effettua due chiamate ricorsive sulle due metà. Il prossimo algoritmo ne effettua soltanto una: dopo un solo confronto, una delle due metà può essere scartata.
17.3.1 L'algoritmo
Dato un array \(a[1..n]\) di \(n\) numeri naturali ordinati in ordine non decrescente e un numero naturale \(m\) da cercare, consideriamo il problema di determinare se \(m\) è uno degli elementi dell'array.
-
Nel capitolo «Ricerca lineare e binaria» abbiamo risolto questo problema con l'algoritmo iterativo
BinarySearch: l'algoritmo mantiene un intervallo di ricerca \(a[left..right]\), inizialmente \(a[1..n]\), e a ogni iterazione confronta il valore cercato \(m\) con l'elemento centrale\[ a[mid], \qquad mid = left + \left\lfloor \frac{right-left}{2} \right\rfloor . \]Se \(a[mid]=m\) l'elemento è stato trovato; altrimenti, poiché l'array è ordinato, metà dell'intervallo può essere scartata.
-
L'osservazione chiave è che, dopo il confronto con \(a[mid]\), il problema che resta da risolvere è lo stesso problema (cercare \(m\) in un array ordinato) su un sotto-array più piccolo:
-
se \(a[mid] < m\), allora \(m\) può trovarsi solo in \(a[mid+1..right]\);
-
se \(a[mid] > m\), allora \(m\) può trovarsi solo in \(a[left..mid-1]\).
-
-
Questa è esattamente la struttura richiesta da un algoritmo ricorsivo: risolviamo il problema su \(a[left..right]\) risolvendo lo stesso problema su un sotto-array di dimensione (circa) metà. I casi base sono l'intervallo vuoto (\(left > right\)), in cui \(m\) certamente non è presente, e il caso \(a[mid]=m\), in cui \(m\) viene trovato.
-
A differenza della versione iterativa, i limiti \(left\) e \(right\) sono ora parametri della funzione. Per cercare \(m\) nell'intero array, chiamiamo
\[ \texttt{RecursiveBinarySearch}(a,1,n,m). \] -
Questo è lo pseudocodice dell'algoritmo di ricerca binaria ricorsiva:
Algoritmo: RecursiveBinarySearch
-
Spiegazione dell'algoritmo:
-
Righe 2–3: se l'intervallo è vuoto (\(left > right\)), l'elemento non è presente e viene restituito \(-1\) (caso base).
-
Riga 5: l'indice centrale \(mid\) viene calcolato con la stessa formula dell'algoritmo iterativo.
-
Righe 6–7: se \(a[mid] = m\), l'elemento è stato trovato e il suo indice viene restituito (caso base).
-
Righe 9–10: se \(a[mid] < m\), la ricerca prosegue ricorsivamente nella metà destra \(a[mid+1..right]\).
-
Riga 12: altrimenti \(a[mid] > m\), e la ricerca prosegue ricorsivamente nella metà sinistra \(a[left..mid-1]\).
-
Il valore restituito dalla chiamata ricorsiva viene restituito invariato al chiamante.
-
-
Ogni chiamata di
RecursiveBinarySearcheffettua al più una chiamata ricorsiva. Quindi, l'albero delle chiamate è un cammino: non ha ramificazioni. Questo è molto diverso dal Merge Sort, in cui ogni chiamata su un array con almeno due elementi genera due chiamate ricorsive.
17.3.2 Esempi
- Consideriamo le stesse ricerche eseguite nel capitolo «Ricerca lineare e binaria» con l'algoritmo iterativo. Per ogni ricerca riportiamo una riga per ogni chiamata: i valori di \(left\), \(right\), \(mid\), \(a[mid]\) e l'azione eseguita. Poi disegniamo l'albero delle chiamate: una freccia nera è una chiamata ricorsiva, una freccia blu è il valore restituito al chiamante.
Esempio 17.9: ricerca binaria ricorsiva su un array ordinato
Cerchiamo quattro valori nell'array ordinato \(a = [3, 9, 11, 12, 12, 16, 19]\) (\(n=7\)).
-
Ricerca di \(m = 12\). Prima chiamata
RecursiveBinarySearch\((a,1,7,12)\):chiamata \(left\) \(right\) \(mid\) \(a[mid]\) azione \(1\) 1 7 4 12 \(a[mid] = m\) \(\Rightarrow\) Trovato! Ritorna \(4\) 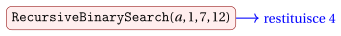
L'elemento 12 viene trovato all'indice 4 con una sola chiamata (nessuna ricorsione).
-
Ricerca di \(m = 10\). Prima chiamata
RecursiveBinarySearch\((a,1,7,10)\):chiamata \(left\) \(right\) \(mid\) \(a[mid]\) azione \(1\) 1 7 4 12 \(a[mid] > m\) \(\Rightarrow\) chiama \(left=1\), \(right = 3\) \(2\) 1 3 2 9 \(a[mid] < m\) \(\Rightarrow\) chiama \(left=3\), \(right = 3\) \(3\) 3 3 3 11 \(a[mid] > m\) \(\Rightarrow\) chiama \(left=3\), \(right = 2\) \(4\) 3 2 – – \(left > right\) \(\Rightarrow\) Non trovato! Ritorna \(-1\) 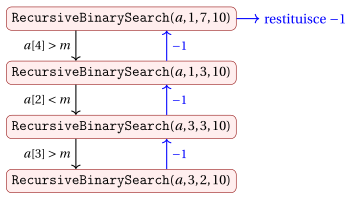
L'elemento 10 non è nell'array: l'ultima chiamata è su un intervallo vuoto e restituisce \(-1\), e questo valore viene propagato fino alla prima chiamata.
-
Ricerca di \(m = 3\). Prima chiamata
RecursiveBinarySearch\((a,1,7,3)\):chiamata \(left\) \(right\) \(mid\) \(a[mid]\) azione \(1\) 1 7 4 12 \(a[mid] > m\) \(\Rightarrow\) chiama \(left=1\), \(right = 3\) \(2\) 1 3 2 9 \(a[mid] > m\) \(\Rightarrow\) chiama \(left=1\), \(right = 1\) \(3\) 1 1 1 3 \(a[mid] = m\) \(\Rightarrow\) Trovato! Ritorna \(1\) 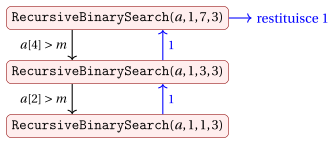
L'elemento 3 viene trovato all'indice 1.
-
Ricerca di \(m = 19\). Prima chiamata
RecursiveBinarySearch\((a,1,7,19)\):chiamata \(left\) \(right\) \(mid\) \(a[mid]\) azione \(1\) 1 7 4 12 \(a[mid] < m\) \(\Rightarrow\) chiama \(left=5\), \(right = 7\) \(2\) 5 7 6 16 \(a[mid] < m\) \(\Rightarrow\) chiama \(left=7\), \(right = 7\) \(3\) 7 7 7 19 \(a[mid] = m\) \(\Rightarrow\) Trovato! Ritorna \(7\) 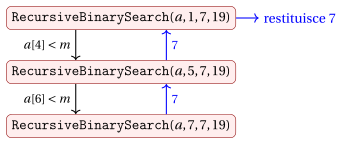
L'elemento 19 viene trovato all'indice 7.
-
La successione dei valori \((left, right, mid)\) è esattamente la stessa prodotta dall'algoritmo iterativo: ogni chiamata dell'algoritmo ricorsivo corrisponde a un'iterazione del ciclo
whiledell'algoritmo iterativo. -
Si noti che la seconda occorrenza di \(12\) (indice 5) non viene mai trovata cercando \(m=12\): come nella versione iterativa, l'algoritmo restituisce un indice \(i\) con \(a[i]=m\), non necessariamente il primo.
17.3.3 Correttezza
-
Come per gli algoritmi precedenti, la correttezza si dimostra per induzione forte sulla dimensione dell'input della chiamata. La dimensione della chiamata
RecursiveBinarySearch\((a,left,right,m)\) è il numero di elementi dell'intervallo:\[ k = right - left + 1 . \]Per un intervallo vuoto (\(left = right+1\)) si ha \(k=0\).
Teorema 17.6: correttezza della ricerca binaria ricorsiva
Sia \(a[1..n]\) ordinato in ordine non decrescente e siano \(1 \le left \le right+1 \le n+1\). Allora RecursiveBinarySearch\((a,left,right,m)\) termina e restituisce:
-
un indice \(i \in \{left,\dots,right\}\) tale che \(a[i]=m\), se \(m\) è uno degli elementi di \(a[left..right]\);
-
\(-1\), altrimenti.
Dimostrazione
Procediamo per induzione forte su \(k = right-left+1 \ge 0\).
Caso base \(k=0\). Allora \(left > right\), l'intervallo è vuoto e \(m\) non è uno dei suoi elementi. L'algoritmo esegue le righe 2–3 e restituisce \(-1\), il che è corretto.
Passo induttivo. Sia \(k \ge 1\) e supponiamo (ipotesi induttiva) che l'enunciato valga per ogni chiamata il cui intervallo ha dimensione \(k' < k\). Poiché \(left \le right\), l'algoritmo calcola
-
Se \(a[mid]=m\), l'algoritmo restituisce \(mid \in \{left,\dots,right\}\), il che è corretto.
-
Se \(a[mid] < m\), allora, poiché l'array è ordinato, \(a[i] \le a[mid] < m\) per ogni \(i \in \{left,\dots,mid\}\). Quindi \(m\) è in \(a[left..right]\) se e solo se è in \(a[mid+1..right]\). Questo intervallo ha dimensione \(right-mid < k\) (perché \(mid \ge left\)), quindi per l'ipotesi induttiva la chiamata
RecursiveBinarySearch\((a,mid+1,right,m)\) termina e restituisce una risposta corretta, che viene restituita invariata. -
Se \(a[mid] > m\), allora \(a[i] \ge a[mid] > m\) per ogni \(i \in \{mid,\dots,right\}\). Quindi \(m\) è in \(a[left..right]\) se e solo se è in \(a[left..mid-1]\), un intervallo di dimensione \(mid-left < k\) (perché \(mid \le right\)). Per l'ipotesi induttiva, la chiamata ricorsiva restituisce una risposta corretta.
In tutti i casi la chiamata termina e restituisce una risposta corretta. □
- Applicando il Teorema 17.6 con \(left=1\) e \(right=n\), otteniamo che
RecursiveBinarySearch\((a,1,n,m)\) risolve il problema.
17.3.4 Tempo di esecuzione nel caso peggiore
L'equazione di ricorrenza
-
Sia \(S(n)\) il numero di passi eseguiti da
RecursiveBinarySearchnel caso peggiore su un intervallo di \(n = right-left+1\) elementi (compresi i passi eseguiti da tutte le chiamate ricorsive). -
Il numero di passi eseguiti da una singola chiamata, senza contare i passi della chiamata ricorsiva, è:
-
Dimensione dei sottoproblemi. Sia \(n = right-left+1 \ge 1\). Poiché \(mid - left = \lfloor (n-1)/2 \rfloor\):
-
l'intervallo sinistro \(a[left..mid-1]\) ha \(mid-left = \left\lfloor \frac{n-1}{2}\right\rfloor\) elementi;
-
l'intervallo destro \(a[mid+1..right]\) ha \(right-mid = (n-1) - \left\lfloor \frac{n-1}{2}\right\rfloor = \left\lceil \frac{n-1}{2}\right\rceil = \left\lfloor \frac{n}{2}\right\rfloor\) elementi.
Per esempio, per \(n=7\) entrambe le metà hanno \(3\) elementi; per \(n=8\) la metà sinistra ha \(3\) elementi e la metà destra ne ha \(4\).
-
-
Nel caso peggiore l'elemento non viene trovato prima che l'intervallo diventi vuoto, e la ricorsione prosegue sulla metà più grande, che ha \(\lfloor n/2 \rfloor\) elementi (si verifica facilmente per induzione che \(S\) è non decrescente). Quindi, \(S(n)\) soddisfa l'equazione di ricorrenza
\[ S(n) = \begin{cases} 2 & \text{se } n = 0,\\[2mm] S\big(\lfloor n/2 \rfloor\big) + 5 & \text{se } n \ge 1. \end{cases} \]Questo caso peggiore si verifica, per esempio, quando \(m > a[n]\): l'algoritmo prosegue sempre nella metà destra, finché l'intervallo diventa vuoto.
-
In generale, scriviamo
\[ S(n) = S\big(\lfloor n/2 \rfloor\big) + c , \]dove \(c\) è una costante (qui \(c=5\)): un algoritmo ricorsivo che riduce il problema a un sottoproblema di dimensione metà, svolgendo una quantità costante di lavoro aggiuntivo.
Soluzione per espansione
-
Espandiamo l'equazione di ricorrenza, usando la proprietà \(\big\lfloor \lfloor n/2^i \rfloor / 2 \big\rfloor = \lfloor n/2^{i+1} \rfloor\):
\[ \begin{aligned} S(n) &= S\big(\lfloor n/2 \rfloor\big) + 5 \\ &= S\big(\lfloor n/4 \rfloor\big) + 5 + 5 \\ &= S\big(\lfloor n/8 \rfloor\big) + 5\cdot 3 \\ &\;\;\vdots \\ &= S\big(\lfloor n/2^j \rfloor\big) + 5\, j . \end{aligned} \] -
L'espansione si ferma al primo \(j\) tale che \(\lfloor n/2^j \rfloor = 0\), cioè \(2^j > n\). Per \(n\ge 1\), questo è
\[ j = \lfloor \log_2 n \rfloor + 1 , \]perché \(2^{\lfloor \log_2 n\rfloor} \le n < 2^{\lfloor \log_2 n \rfloor +1}\). Quindi, per ogni \(n \ge 1\),
\[ S(n) = 5\big(\lfloor \log_2 n \rfloor + 1\big) + 2 . \] -
Per esempio, \(S(7) = 5\cdot(2+1)+2 = 17\): nella ricerca di \(m=10\) dell'Esempio 17.9, le tre chiamate su intervalli non vuoti eseguono \(5\) passi ciascuna e l'ultima chiamata (intervallo vuoto) ne esegue \(2\).
-
Poiché \(\log_2 n - 1 < \lfloor \log_2 n \rfloor \le \log_2 n\), abbiamo
\[ \lim_{n\to\infty}\frac{S(n)}{\log_2 n} = \lim_{n\to\infty}\frac{5\lfloor \log_2 n \rfloor + 7}{\log_2 n} = 5 \in \R_{>0}, \qquad\text{quindi}\qquad S(n) = \Theta(\log_2 n). \]
Soluzione con il Master theorem
-
Lo stesso risultato si ottiene immediatamente con il Master theorem, applicato a
\[ S(n) = S(n/2) + c \](come di consueto, le parti intere inferiori non cambiano la soluzione asintotica).
-
Identificare \(a\), \(b\), \(f(n)\): \(a = 1\), \(b = 2\), \(f(n) = c\).
-
Calcolare \(n^{\log_b a} = n^{\log_2 1} = n^0 = 1\).
-
Confrontare: \(f(n) = c = \Theta(1) = \Theta\big(n^{\log_2 1}\log^0 n\big)\).
-
Verificare l'ipotesi: siamo nel caso 2 del Master theorem con \(k = 0\).
-
Concludere:
\[ S(n) = \Theta\big(n^{\log_2 1}\log^{0+1} n\big) = \Theta(\log n) = \Theta(\log_2 n). \]
-
Numero di chiamate ricorsive
- Ogni chiamata su un intervallo non vuoto confronta \(m\) con esattamente un elemento \(a[mid]\). Quindi, il numero di chiamate su un intervallo non vuoto è il numero di elementi dell'array esaminati dall'algoritmo (esattamente come il numero di iterazioni del ciclo
whiledell'algoritmo iterativo).
Osservazione 17.7: numero di chiamate della ricerca binaria ricorsiva
Per \(n \ge 1\), la chiamata RecursiveBinarySearch\((a,1,n,m)\) esegue al più
chiamate su un intervallo non vuoto, e questo limite viene raggiunto (per esempio quando \(m > a[n]\)). Contando anche l'ultima chiamata su un intervallo vuoto, il numero totale di chiamate è al più \(\lfloor \log_2 n \rfloor + 2\).
Dimostrazione
Sia \(n_i\) la dimensione dell'intervallo della \(i\)-esima chiamata (\(i=1\) è la prima chiamata, quindi \(n_1 = n\)). Per l'analisi dei sottoproblemi, \(n_{i+1} \le \lfloor n_i/2 \rfloor\). Per induzione su \(i\),
vale per \(i=1\), e se vale per \(i\) allora \(n_{i+1} \le \lfloor n_i/2\rfloor \le \big\lfloor \lfloor n/2^{i-1}\rfloor/2\big\rfloor = \lfloor n/2^{i}\rfloor\).
Se la \(i\)-esima chiamata è su un intervallo non vuoto, allora \(n_i \ge 1\), quindi \(n/2^{i-1} \ge 1\), cioè \(2^{i-1} \le n\) e \(i-1 \le \log_2 n\). Poiché \(i-1\) è un intero, \(i-1 \le \lfloor \log_2 n \rfloor\), cioè
Quindi, al più \(\lfloor \log_2 n \rfloor + 1\) chiamate sono su un intervallo non vuoto, e può seguirne al più un'altra (su un intervallo vuoto, che non effettua chiamate ricorsive).
Se \(m > a[n]\), l'algoritmo prosegue sempre nella metà destra, la cui dimensione è esattamente \(\lfloor n_i/2 \rfloor\). Quindi \(n_i = \lfloor n/2^{i-1} \rfloor\), che è \(\ge 1\) per \(i = \lfloor \log_2 n\rfloor + 1\): il limite viene raggiunto, ed è seguito da una chiamata su un intervallo vuoto. □
-
Per esempio, per \(n = 7\) si ha \(\lfloor \log_2 7 \rfloor + 1 = 3\): nella ricerca di \(m = 10\) ci sono \(3\) chiamate su intervalli non vuoti, più l'ultima chiamata sull'intervallo vuoto \(left=3\), \(right=2\).
-
Lo stesso ragionamento mostra che anche l'algoritmo iterativo esegue al più \(\lfloor \log_2 n \rfloor + 1\) iterazioni del ciclo
while.
Tempo di esecuzione nel caso peggiore in funzione della dimensione dell'input
-
L'input dell'algoritmo è costituito dall'array \(a[1..n]\) e dal valore cercato \(m\). Sotto l'ipotesi che ogni valore usi un numero costante di bit, la dimensione dell'input soddisfa
\[ |I| = \Theta(n), \]cioè esistono costanti \(c_1,c_2>0\) tali che \(c_1 n \le |I| \le c_2 n\) per ogni \(n\) sufficientemente grande. Passando ai logaritmi,
\[ \log_2 |I| - \log_2 c_2 \le \log_2 n \le \log_2 |I| - \log_2 c_1 , \]quindi \(\log_2 n = \Theta(\log_2 |I|)\) (le costanti additive sono trascurabili rispetto a \(\log_2 |I|\)).
-
Poiché \(S(n) = \Theta(\log_2 n)\), otteniamo \(S(n) = \Theta(\log_2 |I|)\).
Se tutti i valori in ingresso usano un numero costante fissato di bit, allora il tempo di esecuzione nel caso peggiore dell'algoritmo RecursiveBinarySearch è
Quindi, come la versione iterativa, l'algoritmo è logaritmico nella dimensione dell'input: non è necessario leggere l'intero input per risolvere il problema, perché l'array è ordinato.
17.3.5 Spazio: ricerca binaria ricorsiva contro iterativa
-
L'algoritmo ricorsivo e quello iterativo eseguono gli stessi confronti e hanno lo stesso tempo di esecuzione nel caso peggiore. Differiscono per la memoria usata.
-
Ogni chiamata che non è ancora terminata mantiene in memoria una propria copia dei parametri e delle variabili locali (\(left\), \(right\), \(m\), \(mid\), un riferimento all'array e l'indirizzo di ritorno). Queste informazioni sono memorizzate nella pila delle chiamate, e occupano una quantità costante di memoria per chiamata.
-
In
RecursiveBinarySearchnessuna chiamata termina prima che sia terminata la sua chiamata ricorsiva. Quindi, quando è in esecuzione l'ultima chiamata, tutte le chiamate del cammino sono nella pila delle chiamate. Per l'Osservazione 17.7, nel caso peggiore sono \(\lfloor \log_2 n \rfloor + 2\), e la memoria aggiuntiva usata è\[ \Theta(\log n). \] -
L'algoritmo iterativo usa solo le variabili \(left\), \(right\) e \(mid\): la sua memoria aggiuntiva è
\[ \Theta(1). \]
Definizione 17.8: ricorsione in coda
Una chiamata ricorsiva è una chiamata in coda (tail call) se è l'ultima operazione eseguita dalla funzione chiamante, cioè il valore che restituisce viene restituito direttamente dal chiamante senza ulteriori calcoli. Una funzione le cui chiamate ricorsive sono tutte chiamate in coda si dice ricorsiva in coda (tail recursive).
-
RecursiveBinarySearchè ricorsiva in coda: nelle righe 10 e 12 il valore della chiamata ricorsiva viene restituito così com'è. -
Una chiamata in coda si può sostituire aggiornando i parametri e tornando all'inizio della funzione:
-
la riga 10 diventa \(left \leftarrow mid+1\);
-
la riga 12 diventa \(right \leftarrow mid-1\);
-
il test della riga 2 diventa la condizione di un ciclo
while«while \(left \le right\)».
Il risultato di questa trasformazione è esattamente l'algoritmo iterativo
BinarySearch. Ecco perché i due algoritmi producono la stessa successione di valori di \(left\), \(right\) e \(mid\). -
-
Molti compilatori eseguono automaticamente questa trasformazione (eliminazione delle chiamate in coda, tail-call elimination), in modo che la versione ricorsiva usi solo \(\Theta(1)\) di memoria aggiuntiva. Per esempio, il compilatore
g++15.2 elimina le chiamate ricorsive di un'implementazioneC++dell'algoritmo con l'opzione-O2, ma non con-O0. Tuttavia, questo non è garantito dallo standardC++.
La ricerca binaria ricorsiva e quella iterativa hanno lo stesso tempo di esecuzione nel caso peggiore \(\Theta(\log n)\), ma la versione ricorsiva usa \(\Theta(\log n)\) di memoria aggiuntiva per la pila delle chiamate, mentre la versione iterativa usa \(\Theta(1)\) di memoria aggiuntiva. Ogni algoritmo ricorsivo in coda può essere trasformato in uno iterativo.
Punti chiave sulla ricerca binaria ricorsiva.
-
Una chiamata ricorsiva su (al più) metà dell'intervallo: l'albero delle chiamate è un cammino, con al più \(\lfloor\log_2 n\rfloor+2\) chiamate.
-
\(S(n)=S(\lfloor n/2\rfloor)+5\), cioè \(S(n)=5(\lfloor\log_2 n\rfloor+1)+2=\Theta(\log n)\) (caso 2 del Master theorem con \(a=1\)).
-
L'algoritmo è ricorsivo in coda: eliminando la ricorsione si ottiene l'algoritmo iterativo
BinarySearch, con \(\Theta(1)\) di memoria aggiuntiva invece di \(\Theta(\log n)\).
17.4 Il problema del sotto-array di somma massima
L'ultimo problema del capitolo mostra il divide et impera al lavoro su un problema meno ovvio, in cui il passo combina è la parte interessante. Mostra anche che un algoritmo ricorsivo che migliora la forza bruta non è necessariamente il migliore possibile.
17.4.1 Motivazione: comprare e vendere un'azione
-
Supponiamo di conoscere in anticipo il prezzo di un'azione per i giorni successivi. Possiamo comprare un'unità di azione una volta e venderla una volta, in un giorno successivo. Vogliamo massimizzare il profitto (prezzo di vendita meno prezzo di acquisto).
-
Questo è un esempio1: \(p[d]\) è il prezzo al giorno \(d\), e \(a[d] = p[d]-p[d-1]\) è la variazione giornaliera del prezzo.
| giorno \(d\) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| prezzo \(p[d]\) | 100 | 113 | 110 | 85 | 105 | 102 | 86 | 63 | 81 | 101 | 94 | 106 | 101 | 79 | 94 | 90 | 97 |
| variazione \(a[d]\) | 13 | \(-3\) | \(-25\) | 20 | \(-3\) | \(-16\) | \(-23\) | 18 | 20 | \(-7\) | 12 | \(-5\) | \(-22\) | 15 | \(-4\) | 7 |
-
Se compriamo al giorno \(l-1\) e vendiamo al giorno \(r \ge l\), il profitto è
\[ p[r]-p[l-1] = \big(p[l]-p[l-1]\big) + \big(p[l+1]-p[l]\big) + \cdots + \big(p[r]-p[r-1]\big) = a[l]+a[l+1]+\cdots+a[r], \]cioè la somma delle variazioni giornaliere consecutive \(a[l..r]\). Quindi, massimizzare il profitto equivale a trovare la porzione consecutiva dell'array \(a[1..16]\) con la somma più grande.
-
Si noti che non basta comprare al prezzo più basso o vendere al prezzo più alto: il prezzo più basso (\(63\), giorno \(7\)) viene dopo il prezzo più alto (\(113\), giorno \(1\)). In questo esempio la scelta migliore è comprare al giorno \(7\) (prezzo \(63\)) e vendere al giorno \(11\) (prezzo \(106\)), con profitto
\[ 106 - 63 = 43 = a[8]+a[9]+a[10]+a[11] = 18+20-7+12 . \]
17.4.2 Il problema
Dato un array \(a[1..n]\) di \(n\) numeri interi, consideriamo il problema di trovare due indici \(l \le r\) tali che la somma
sia massima. Il sotto-array \(a[l..r]\) si chiama sotto-array di somma massima di \(a\).
-
Un sotto-array è sempre non vuoto (\(l \le r\)) e formato da elementi consecutivi.
-
Il problema è interessante solo se l'array contiene numeri negativi: se tutti gli elementi sono non negativi, l'intero array \(a[1..n]\) è un sotto-array di somma massima. Se tutti gli elementi sono negativi, un sotto-array di somma massima è formato da un solo elemento, il più grande.
-
Un sotto-array di somma massima non è necessariamente unico: ne cerchiamo uno.
-
Il numero di sotto-array di \(a[1..n]\) è il numero di coppie \((l,r)\) con \(1 \le l \le r \le n\):
\[ \sum_{l=1}^{n} (n-l+1) = n + (n-1) + \cdots + 1 = \frac{n(n+1)}{2}. \]
17.4.3 Un algoritmo di forza bruta
-
L'algoritmo più semplice considera tutti gli \(n(n+1)/2\) sotto-array \(a[l..r]\) e tiene il migliore. Per un \(l\) fissato, le somme di \(a[l..r]\) per \(r = l, l+1, \dots, n\) si calcolano in modo incrementale: la somma di \(a[l..r]\) è la somma di \(a[l..r-1]\) più \(a[r]\).
-
Questo è lo pseudocodice dell'algoritmo
BruteForceMaximumSubarray:
Algoritmo: BruteForceMaximumSubarray
Esempio 17.11: algoritmo di forza bruta
Consideriamo \(a = [-2, 5, -1, 3]\). L'algoritmo parte con \(best = a[1] = -2\) ed esamina i \(4\cdot 5/2 = 10\) sotto-array in quest'ordine:
| \(l\) | \(r\) | \(sum\) | azione |
|---|---|---|---|
| 1 | 1 | \(-2\) | \(sum \le best = -2\) |
| 1 | 2 | \(3\) | \(sum > best\) \(\Rightarrow\) \(best = 3\), \(bl=1\), \(br=2\) |
| 1 | 3 | \(2\) | |
| 1 | 4 | \(5\) | \(sum > best\) \(\Rightarrow\) \(best = 5\), \(bl=1\), \(br=4\) |
| 2 | 2 | \(5\) | \(sum \le best = 5\) |
| 2 | 3 | \(4\) | |
| 2 | 4 | \(7\) | \(sum > best\) \(\Rightarrow\) \(best = 7\), \(bl=2\), \(br=4\) |
| 3 | 3 | \(-1\) | |
| 3 | 4 | \(2\) | |
| 4 | 4 | \(3\) |
L'algoritmo restituisce \((2,4,7)\): il sotto-array di somma massima è \(a[2..4] = [5,-1,3]\) con somma \(7\).
Tempo di esecuzione nel caso peggiore
-
Sia \(S(n)\) il numero di passi eseguiti da
BruteForceMaximumSubarraynel caso peggiore, dove \(n\) è la dimensione dell'array. -
L'esecuzione delle righe 12–14 dipende dall'input. Definiamo una funzione \(t(l,r) \in \{0,1\}\), per \(1 \le l \le r \le n\), dove \(t(l,r)=1\) se le righe 12–14 vengono eseguite quando il ciclo interno esamina la coppia \((l,r)\), e \(t(l,r)=0\) altrimenti.
-
Per un \(l\) fissato, il ciclo interno esegue \(n-l+1\) iterazioni, e la sua condizione viene verificata \(n-l+2\) volte. Quindi
\[ \sum_{l=1}^{n}(n-l+1) = \frac{n(n+1)}{2}, \qquad \sum_{l=1}^{n}(n-l+2) = \frac{n(n+1)}{2} + n . \] -
Il numero di volte che ciascuna riga di codice viene eseguita è:
-
La riga 6 viene eseguita \(n+1\) volte
-
La riga 9 viene eseguita \(\frac{n(n+1)}{2} + n\) volte
-
Le righe 10, 11 e 16 vengono eseguite \(\frac{n(n+1)}{2}\) volte ciascuna
-
Le righe 12, 13, 14 vengono eseguite \(\sum_{l=1}^{n}\sum_{r=l}^{n} t(l,r)\) volte ciascuna
-
La riga 18 viene eseguita \(n\) volte
-
La riga 20 viene eseguita \(1\) volta
-
Quindi, il numero totale di passi è
\[ \begin{aligned} &4 + (n+1) + 2n + \frac{n(n+1)}{2} + n + 3\,\frac{n(n+1)}{2} + n + 1 + 3\sum_{l=1}^{n}\sum_{r=l}^{n} t(l,r)\\[1ex] &= 2n^2 + 7n + 6 + 3\sum_{l=1}^{n}\sum_{r=l}^{n} t(l,r). \end{aligned} \]Nell'Esempio 17.11 ci sono \(3\) aggiornamenti e l'algoritmo esegue \(2\cdot 16+7\cdot 4+6+3\cdot 3=75\) passi.
-
Poiché \(0 \le t(l,r) \le 1\), la somma doppia è compresa tra \(0\) e \(n(n+1)/2\). Quindi, per ogni input di dimensione \(n\), il numero di passi è compreso tra
\[ 2n^2+7n+6 \qquad\text{e}\qquad 2n^2+7n+6+\frac{3n(n+1)}{2} = \frac{7}{2}n^2 + \frac{17}{2}n + 6 , \]e lo stesso vale per il numero di passi nel caso peggiore \(S(n)\). Entrambi i limiti sono \(\Theta(n^2)\); per esempio,
\[ \lim_{n\to\infty}\frac{2n^2+7n+6}{n^2} = 2 \in \R_{>0}, \qquad \lim_{n\to\infty}\frac{\frac{7}{2}n^2+\frac{17}{2}n+6}{n^2} = \frac{7}{2} \in \R_{>0}. \]Quindi,
\[ S(n) = \Theta(n^2). \]Si noti che, per ogni input (non solo nel caso peggiore), l'algoritmo esegue \(\Theta(n^2)\) passi, poiché esamina sempre tutti gli \(n(n+1)/2\) sotto-array.
-
Sotto l'ipotesi che ogni elemento usi un numero costante di bit, \(|I| = \Theta(n)\), e quindi \(S(n) = \Theta(|I|^2)\).
Se tutti i valori in ingresso usano un numero costante fissato di bit, allora il tempo di esecuzione nel caso peggiore dell'algoritmo BruteForceMaximumSubarray è
Quindi, l'algoritmo di forza bruta è quadratico nella dimensione dell'input.
17.4.4 Un algoritmo divide et impera
-
Progettiamo ora un algoritmo ricorsivo basato sull'approccio divide et impera, come per il Merge Sort. Risolviamo il problema su un sotto-array \(a[l..r]\), e lo chiamiamo inizialmente con \(l=1\) e \(r=n\).
-
Divide: si suddivide \(a[l..r]\) in due metà \(a[l..mid]\) e \(a[mid+1..r]\), dove
\[ mid = \left\lfloor \frac{l+r}{2} \right\rfloor \quad \Big(= l + \left\lfloor \frac{r-l}{2} \right\rfloor\Big). \] -
Ogni sotto-array \(a[i..j]\) di \(a[l..r]\) (con \(l \le i \le j \le r\)) si trova in una e una sola di queste tre situazioni:
-
si trova interamente nella metà sinistra: \(l \le i \le j \le mid\);
-
si trova interamente nella metà destra: \(mid+1 \le i \le j \le r\);
-
attraversa il punto medio: \(l \le i \le mid < j \le r\).
-
-
Impera: un sotto-array di somma massima di tipo 1 e uno di tipo 2 si trovano ricorsivamente, poiché sono sotto-array di somma massima di \(a[l..mid]\) e \(a[mid+1..r]\), rispettivamente.
-
Combina: un sotto-array di somma massima di tipo 3 si trova con una procedura non ricorsiva,
FindMaxCrossingSubarray, descritta qui sotto. La risposta è il migliore dei tre sotto-array.
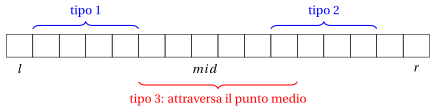
Sotto-array di somma massima che attraversa il punto medio
-
Un sotto-array che attraversa il punto medio è formato da due parti: \(a[i..mid]\), che termina in \(mid\), e \(a[mid+1..j]\), che inizia in \(mid+1\):
\[ \sum_{k=i}^{j} a[k] = \sum_{k=i}^{mid} a[k] + \sum_{k=mid+1}^{j} a[k] . \]Il primo termine dipende solo da \(i\), il secondo solo da \(j\): le due parti si possono scegliere indipendentemente. Quindi, basta trovare il miglior \(i\) (scorrendo la metà sinistra da \(mid\) fino a \(l\)) e il miglior \(j\) (scorrendo la metà destra da \(mid+1\) fino a \(r\)).
-
Questo è lo pseudocodice dell'algoritmo
FindMaxCrossingSubarray(dallo stesso libro di testo dell'esempio sull'azione):
Algoritmo: FindMaxCrossingSubarray
Lemma 17.9: sotto-array che attraversa il punto medio
Sia \(l \le mid < r\). FindMaxCrossingSubarray\((a,l,mid,r)\) restituisce \((maxleft, maxright, s)\) con \(l \le maxleft \le mid < maxright \le r\) e
Inoltre, esegue \(\Theta(n)\) passi, dove \(n = r-l+1\).
Dimostrazione
Ciclo sinistro. Alla fine dell'iterazione con indice \(i\), la variabile \(sum\) è uguale a \(L(i) = \sum_{k=i}^{mid} a[k]\), e \(leftsum\) è il massimo tra \(L(mid), L(mid-1), \dots, L(i)\), raggiunto in \(maxleft\) (per induzione sulle iterazioni: a ogni iterazione \(sum\) viene confrontato con il miglior valore trovato finora, che inizialmente è \(-\infty\), quindi il primo confronto ha sempre successo). Alla fine del ciclo,
Ciclo destro. Allo stesso modo, con \(R(j) = \sum_{k=mid+1}^{j} a[k]\),
Combinazione. Per ogni sotto-array che attraversa il punto medio, \(\sum_{k=i}^{j} a[k] = L(i) + R(j)\). Poiché \(i\) e \(j\) si possono scegliere indipendentemente,
che è il valore restituito, raggiunto da \(a[maxleft..maxright]\).
Tempo di esecuzione. I due cicli eseguono \((mid-l+1) + (r-mid) = r-l+1 = n\) iterazioni in totale, ciascuna con un numero costante di passi (tra \(3\) e \(5\) righe, contando il test del ciclo), più un numero costante di passi fuori dai cicli. Quindi il numero di passi è compreso tra \(c_1 n\) e \(c_2 n\) per due costanti \(c_1, c_2 > 0\), cioè \(\Theta(n)\). □
- Si noti che il sotto-array che attraversa il punto medio contiene sempre sia \(a[mid]\) sia \(a[mid+1]\), anche se sono negativi: i sotto-array di tipo 1 e 2 si occupano degli altri casi.
L'algoritmo ricorsivo
- Questo è lo pseudocodice dell'algoritmo
FindMaximumSubarray. Per risolvere il problema sull'intero array chiamiamoFindMaximumSubarray\((a,1,n)\).
Algoritmo: FindMaximumSubarray
-
Spiegazione dell'algoritmo:
-
Righe 2–3: se il sotto-array ha un solo elemento, il suo unico sotto-array è \(a[l..l]\) (caso base).
-
Riga 5: divide il sotto-array in \(a[l..mid]\) e \(a[mid+1..r]\).
-
Righe 6–7: impera, cioè trova ricorsivamente un sotto-array di somma massima in ciascuna metà.
-
Riga 8: trova un sotto-array di somma massima che attraversa il punto medio.
-
Righe 9–15: combina, cioè restituisce il migliore dei tre (in caso di parità, si preferisce quello di sinistra, poi quello di destra).
-
-
A differenza della ricerca binaria ricorsiva, ogni chiamata su almeno due elementi effettua due chiamate ricorsive: l'albero delle chiamate è un albero binario con \(n\) foglie (una per ogni elemento) e \(n-1\) nodi interni, cioè \(2n-1\) chiamate in totale, esattamente come per
RecursiveSum(Osservazione 17.2).
Esempio
Esempio 17.12: divide et impera sull'esempio dell'azione in borsa
Consideriamo l'array delle variazioni giornaliere dell'esempio dell'azione:
- Passo 1: l'albero delle chiamate. Chiamiamo
FindMaximumSubarray\((a,1,16)\). Nel seguente albero, ogni nodo è una chiamata su \(a[l..r]\), scritta come \([l..r]\), insieme alla terna \((i,j,s)\) che restituisce. Le \(16\) foglie (chiamate su un elemento \([k..k]\), che restituiscono \((k,k,a[k])\)) non sono disegnate.
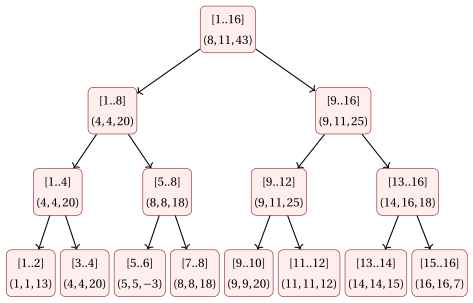
- Passo 2: i risultati delle chiamate. Per ogni chiamata su almeno due elementi, riportiamo le terne restituite dalla chiamata ricorsiva sinistra, dalla chiamata ricorsiva destra e da
FindMaxCrossingSubarray, e la terna restituita (la migliore delle tre).
| chiamata | \(mid\) | sinistra | destra | attraversante | restituita |
|---|---|---|---|---|---|
| \([1..16]\) | 8 | \((4,4,20)\) | \((9,11,25)\) | \((8,11,43)\) | \((8,11,43)\) |
| \([1..8]\) | 4 | \((4,4,20)\) | \((8,8,18)\) | \((4,5,17)\) | \((4,4,20)\) |
| \([9..16]\) | 12 | \((9,11,25)\) | \((14,16,18)\) | \((9,16,16)\) | \((9,11,25)\) |
| \([1..4]\) | 2 | \((1,1,13)\) | \((4,4,20)\) | \((1,4,5)\) | \((4,4,20)\) |
| \([5..8]\) | 6 | \((5,5,-3)\) | \((8,8,18)\) | \((6,8,-21)\) | \((8,8,18)\) |
| \([9..12]\) | 10 | \((9,9,20)\) | \((11,11,12)\) | \((9,11,25)\) | \((9,11,25)\) |
| \([13..16]\) | 14 | \((14,14,15)\) | \((16,16,7)\) | \((14,16,18)\) | \((14,16,18)\) |
| \([1..2]\) | 1 | \((1,1,13)\) | \((2,2,-3)\) | \((1,2,10)\) | \((1,1,13)\) |
| \([3..4]\) | 3 | \((3,3,-25)\) | \((4,4,20)\) | \((3,4,-5)\) | \((4,4,20)\) |
| \([5..6]\) | 5 | \((5,5,-3)\) | \((6,6,-16)\) | \((5,6,-19)\) | \((5,5,-3)\) |
| \([7..8]\) | 7 | \((7,7,-23)\) | \((8,8,18)\) | \((7,8,-5)\) | \((8,8,18)\) |
| \([9..10]\) | 9 | \((9,9,20)\) | \((10,10,-7)\) | \((9,10,13)\) | \((9,9,20)\) |
| \([11..12]\) | 11 | \((11,11,12)\) | \((12,12,-5)\) | \((11,12,7)\) | \((11,11,12)\) |
| \([13..14]\) | 13 | \((13,13,-22)\) | \((14,14,15)\) | \((13,14,-7)\) | \((14,14,15)\) |
| \([15..16]\) | 15 | \((15,15,-4)\) | \((16,16,7)\) | \((15,16,3)\) | \((16,16,7)\) |
- Passo 3: i calcoli dei sotto-array che attraversano il punto medio per le due chiamate del livello 1. Chiamata \([1..8]\), \(mid = 4\):
| \(i\) | \(a[i]\) | \(sum\) | \(leftsum\) | \(maxleft\) |
|---|---|---|---|---|
| 4 | 20 | 20 | 20 | 4 |
| 3 | \(-25\) | \(-5\) | 20 | 4 |
| 2 | \(-3\) | \(-8\) | 20 | 4 |
| 1 | 13 | 5 | 20 | 4 |
| \(j\) | \(a[j]\) | \(sum\) | \(rightsum\) | \(maxright\) |
|---|---|---|---|---|
| 5 | \(-3\) | \(-3\) | \(-3\) | 5 |
| 6 | \(-16\) | \(-19\) | \(-3\) | 5 |
| 7 | \(-23\) | \(-42\) | \(-3\) | 5 |
| 8 | 18 | \(-24\) | \(-3\) | 5 |
Il sotto-array che attraversa il punto medio è \(a[4..5]\) con somma \(20 + (-3) = 17\). Chiamata \([9..16]\), \(mid = 12\):
| \(i\) | \(a[i]\) | \(sum\) | \(leftsum\) | \(maxleft\) |
|---|---|---|---|---|
| 12 | \(-5\) | \(-5\) | \(-5\) | 12 |
| 11 | 12 | 7 | 7 | 11 |
| 10 | \(-7\) | 0 | 7 | 11 |
| 9 | 20 | 20 | 20 | 9 |
| \(j\) | \(a[j]\) | \(sum\) | \(rightsum\) | \(maxright\) |
|---|---|---|---|---|
| 13 | \(-22\) | \(-22\) | \(-22\) | 13 |
| 14 | 15 | \(-7\) | \(-7\) | 14 |
| 15 | \(-4\) | \(-11\) | \(-7\) | 14 |
| 16 | 7 | \(-4\) | \(-4\) | 16 |
Il sotto-array che attraversa il punto medio è \(a[9..16]\) con somma \(20 + (-4) = 16\).
- Passo 4: il calcolo del sotto-array che attraversa il punto medio per la prima chiamata \([1..16]\), \(mid = 8\):
| \(i\) | \(a[i]\) | \(sum\) | \(leftsum\) | \(maxleft\) |
|---|---|---|---|---|
| 8 | 18 | 18 | 18 | 8 |
| 7 | \(-23\) | \(-5\) | 18 | 8 |
| 6 | \(-16\) | \(-21\) | 18 | 8 |
| 5 | \(-3\) | \(-24\) | 18 | 8 |
| 4 | 20 | \(-4\) | 18 | 8 |
| 3 | \(-25\) | \(-29\) | 18 | 8 |
| 2 | \(-3\) | \(-32\) | 18 | 8 |
| 1 | 13 | \(-19\) | 18 | 8 |
| \(j\) | \(a[j]\) | \(sum\) | \(rightsum\) | \(maxright\) |
|---|---|---|---|---|
| 9 | 20 | 20 | 20 | 9 |
| 10 | \(-7\) | 13 | 20 | 9 |
| 11 | 12 | 25 | 25 | 11 |
| 12 | \(-5\) | 20 | 25 | 11 |
| 13 | \(-22\) | \(-2\) | 25 | 11 |
| 14 | 15 | 13 | 25 | 11 |
| 15 | \(-4\) | 9 | 25 | 11 |
| 16 | 7 | 16 | 25 | 11 |
Il sotto-array che attraversa il punto medio è \(a[8..11]\) con somma \(18 + 25 = 43\).
Nella prima chiamata, la metà sinistra dà \(20\), la metà destra dà \(25\) e il sotto-array che attraversa il punto medio dà \(43\): l'algoritmo restituisce \((8,11,43)\), cioè si compra al giorno \(7\) e si vende al giorno \(11\), con profitto \(43\). Si noti che il sotto-array ottimo viene trovato solo all'ultimo passo, da FindMaxCrossingSubarray: non si trova né nella metà sinistra né nella metà destra.
17.4.5 Correttezza
Teorema 17.10: correttezza di FindMaximumSubarray
Per ogni \(l \le r\), FindMaximumSubarray\((a,l,r)\) restituisce \((i,j,s)\) con \(l \le i \le j \le r\) e
Dimostrazione
Procediamo per induzione forte sul numero di elementi \(n = r-l+1 \ge 1\).
Caso base \(n = 1\). Allora \(l = r\), l'unico sotto-array è \(a[l..l]\), e l'algoritmo restituisce \((l,l,a[l])\), il che è corretto.
Passo induttivo. Sia \(n \ge 2\) e supponiamo (ipotesi induttiva) che l'enunciato valga per ogni sotto-array con \(n' < n\) elementi. Poiché \(l < r\), si ha \(l \le mid < r\), e le due metà \(a[l..mid]\) e \(a[mid+1..r]\) hanno \(\lceil n/2 \rceil\) e \(\lfloor n/2 \rfloor\) elementi, entrambi almeno \(1\) e minori di \(n\). Per l'ipotesi induttiva:
-
\(lsum\) è la somma massima di un sotto-array di tipo 1 (contenuto in \(a[l..mid]\)), raggiunta da \(a[ll..lr]\);
-
\(rsum\) è la somma massima di un sotto-array di tipo 2 (contenuto in \(a[mid+1..r]\)), raggiunta da \(a[rl..rr]\).
Per il Lemma 17.9, \(csum\) è la somma massima di un sotto-array di tipo 3 (che attraversa il punto medio), raggiunta da \(a[cl..cr]\).
Ogni sotto-array di \(a[l..r]\) è di tipo 1, 2 o 3. Quindi la somma massima di un sotto-array di \(a[l..r]\) è
e le righe 9–15 restituiscono esattamente una terna che raggiunge questo massimo. □
17.4.6 Tempo di esecuzione nel caso peggiore
L'equazione di ricorrenza
-
Sia \(S(n)\) il numero di passi eseguiti da
FindMaximumSubarraynel caso peggiore su un sotto-array di \(n = r-l+1\) elementi. -
Se \(n = 1\), vengono eseguite solo le righe 2–3: \(S(1) = c_1\), una costante.
-
If \(n \ge 2\):
-
Quindi,
\[ S(n) = \begin{cases} c_1 & \text{if } n = 1,\\[2mm] S\big(\lceil n/2 \rceil\big) + S\big(\lfloor n/2 \rfloor\big) + \Theta(n) & \text{if } n \ge 2. \end{cases} \]Ignorando le parti intere inferiori e superiori (che non cambiano la soluzione asintotica), otteniamo la stessa equazione di ricorrenza del Merge Sort:
\[ S(n) = 2\,S(n/2) + \Theta(n). \] -
Si noti che il tempo di esecuzione non dipende dai valori nell'array, ma solo da \(n\): ogni input di dimensione \(n\) è un caso peggiore.
Soluzione con il Master theorem
-
Identificare \(a\), \(b\), \(f(n)\): \(a = 2\), \(b = 2\), \(f(n) = \Theta(n)\).
-
Calcolare \(n^{\log_b a} = n^{\log_2 2} = n\).
-
Confrontare: \(f(n) = \Theta(n) = \Theta\big(n^{\log_2 2}\log^0 n\big)\).
-
Verificare l'ipotesi: siamo nel caso 2 del Master theorem con \(k=0\).
-
Concludere:
\[ S(n) = \Theta\big(n^{\log_2 2}\log^{0+1} n\big) = \Theta(n \log n). \]
Soluzione con l'albero di ricorsione
-
Sia \(n = 2^k\) una potenza di \(2\), e sia \(c\,n\) il costo della parte non ricorsiva di una chiamata su \(n \ge 2\) elementi. Nell'albero di ricorsione, il livello \(h\) (per \(h = 0, 1, \dots, k-1\)) contiene \(2^h\) chiamate su \(n/2^h\) elementi ciascuna, con costo totale
\[ 2^h \cdot c\,\frac{n}{2^h} = c\,n . \]L'ultimo livello (\(h = k = \log_2 n\)) contiene le \(n\) foglie, con costo totale \(c_1 n\).
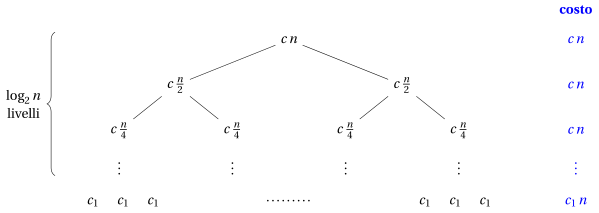
-
Sommando su tutti i livelli:
\[ S(n) = \underbrace{c\,n + c\,n + \cdots + c\,n}_{\log_2 n \text{ volte}} + c_1 n = c\,n\log_2 n + c_1 n = \Theta(n \log n). \] -
L'albero di ricorsione spiega anche il risultato: ci sono \(\log_2 n\) livelli e ogni livello costa \(\Theta(n)\), perché i calcoli dei sotto-array che attraversano il punto medio, per le chiamate di un livello, scorrono tutti insieme l'intero array una sola volta.
Tempo di esecuzione nel caso peggiore in funzione della dimensione dell'input
-
Sotto l'ipotesi che ogni elemento usi un numero costante di bit, \(|I| = \Theta(n)\), e anche \(\log n = \Theta(\log |I|)\) (come mostrato per la ricerca binaria ricorsiva). Quindi
\[ S(n) = \Theta(n\log n) = \Theta(|I| \log |I|). \]
Se tutti i valori in ingresso usano un numero costante fissato di bit, allora il tempo di esecuzione nel caso peggiore dell'algoritmo FindMaximumSubarray è
Quindi, l'algoritmo divide et impera è asintoticamente più veloce dell'algoritmo di forza bruta, il cui tempo di esecuzione nel caso peggiore è \(\Theta(|I|^2)\).
17.4.7 Osservazione: un algoritmo iterativo lineare
-
L'algoritmo divide et impera è molto meglio dell'algoritmo di forza bruta. Tuttavia, il problema del sotto-array di somma massima si può risolvere ancora più velocemente, con un semplice algoritmo iterativo dovuto a J. Kadane, che scorre l'array una sola volta.
-
Idea: per ogni posizione \(i\), sia \(M(i)\) la somma massima di un sotto-array che termina in posizione \(i\). Un sotto-array che termina in \(i\) è o il solo \(a[i]\), oppure un sotto-array che termina in \(i-1\) esteso con \(a[i]\). Quindi,
\[ M(1) = a[1], \qquad M(i) = a[i] + \max\{0, M(i-1)\} \quad (i \ge 2). \]A parole: se il miglior sotto-array che termina in \(i-1\) ha somma negativa, conviene ripartire da \(a[i]\); altrimenti, conviene estenderlo. La risposta al problema è il massimo tra \(M(1), \dots, M(n)\).
-
Questo è lo pseudocodice dell'algoritmo
Kadane. La variabile \(cur\) memorizza \(M(i)\) e \(cl\) il primo indice del sotto-array corrispondente.
Algoritmo: Kadane
Lemma 17.11: invariante di ciclo di Kadane
All'inizio di ogni iterazione del ciclo while (e quando il ciclo termina), con indice corrente \(i\):
-
\(cur = \sum_{k=cl}^{i-1} a[k]\) è la somma massima di un sotto-array che termina in posizione \(i-1\);
-
\(best = \sum_{k=bl}^{br} a[k]\) è la somma massima di un sotto-array di \(a[1..i-1]\).
Dimostrazione
Inizializzazione (\(i = 2\)). L'unico sotto-array che termina in \(1\) è \(a[1..1]\), ed è anche l'unico sotto-array di \(a[1..1]\): \(cur = best = a[1]\) con \(cl = bl = br = 1\).
Mantenimento. Supponiamo che l'invariante valga all'inizio dell'iterazione con indice \(i\). Un sotto-array che termina in \(i\) è o \(a[i..i]\), con somma \(a[i]\), oppure \(a[k..i]\) con \(k < i\), la cui somma è \(\sum_{h=k}^{i-1}a[h] + a[i] \le cur + a[i]\) (per la parte 1), con uguaglianza per \(k = cl\). Quindi la somma massima di un sotto-array che termina in \(i\) è \(\max\{a[i], cur + a[i]\}\), che è \(a[i]\) se \(cur < 0\) e \(cur + a[i]\) altrimenti: è esattamente ciò che calcolano le righe 6–9. Quindi la parte 1 vale per \(i+1\).
Un sotto-array di \(a[1..i]\) o è un sotto-array di \(a[1..i-1]\) (somma migliore: \(best\), per la parte 2) oppure termina in \(i\) (somma migliore: il nuovo \(cur\)). Le righe 11–12 mantengono il maggiore dei due, quindi la parte 2 vale per \(i+1\).
Terminazione. Il ciclo termina con \(i = n+1\): per la parte 2, \(best\) è la somma massima di un sotto-array di \(a[1..n]\), raggiunta da \(a[bl..br]\). □
- Tempo di esecuzione. Il ciclo
whileesegue \(n-1\) iterazioni, ciascuna con un numero costante di passi. Quindi \(S(n) = \Theta(n)\) e, se ogni elemento usa un numero costante di bit, \(T(|I|) = \Theta(|I|)\). Poiché qualunque algoritmo deve leggere tutti gli elementi dell'array, nessun algoritmo può essere asintoticamente più veloce.
Esempio 17.13: algoritmo di Kadane sull'esempio dell'azione
Esecuzione di Kadane su \(a = [13,-3,-25,20,-3,-16,-23,18,20,-7,12,-5,-22,15,-4,7]\). Ogni riga riporta i valori alla fine dell'iterazione con indice \(i\) (riga \(i=1\): inizializzazione).
| \(i\) | \(a[i]\) | azione | \(cur\) | \(cl\) | \(best\) | \((bl,br)\) |
|---|---|---|---|---|---|---|
| 1 | 13 | inizializzazione | 13 | 1 | 13 | \((1,1)\) |
| 2 | \(-3\) | estensione | 10 | 1 | 13 | \((1,1)\) |
| 3 | \(-25\) | estensione | \(-15\) | 1 | 13 | \((1,1)\) |
| 4 | 20 | ripartenza (\(cur<0\)) | 20 | 4 | 20 | \((4,4)\) |
| 5 | \(-3\) | estensione | 17 | 4 | 20 | \((4,4)\) |
| 6 | \(-16\) | estensione | 1 | 4 | 20 | \((4,4)\) |
| 7 | \(-23\) | estensione | \(-22\) | 4 | 20 | \((4,4)\) |
| 8 | 18 | ripartenza (\(cur<0\)) | 18 | 8 | 20 | \((4,4)\) |
| 9 | 20 | estensione | 38 | 8 | 38 | \((8,9)\) |
| 10 | \(-7\) | estensione | 31 | 8 | 38 | \((8,9)\) |
| 11 | 12 | estensione | 43 | 8 | 43 | \((8,11)\) |
| 12 | \(-5\) | estensione | 38 | 8 | 43 | \((8,11)\) |
| 13 | \(-22\) | estensione | 16 | 8 | 43 | \((8,11)\) |
| 14 | 15 | estensione | 31 | 8 | 43 | \((8,11)\) |
| 15 | \(-4\) | estensione | 27 | 8 | 43 | \((8,11)\) |
| 16 | 7 | estensione | 34 | 8 | 43 | \((8,11)\) |
L'algoritmo restituisce \((8,11,43)\), lo stesso sotto-array di somma massima trovato dall'algoritmo divide et impera, dopo un'unica scansione dell'array.
Punti chiave sul problema del sotto-array di somma massima.
-
algoritmo di forza bruta: \(\Theta(n^2)\);
-
algoritmo divide et impera (ricorsivo): \(\Theta(n \log n)\), con la stessa equazione di ricorrenza del Merge Sort;
-
algoritmo di Kadane (iterativo): \(\Theta(n)\).
Un algoritmo ricorsivo divide et impera non è necessariamente il migliore possibile: qui, un semplice algoritmo iterativo che sfrutta la struttura del problema (\(M(i)\) dipende solo da \(M(i-1)\)) è asintoticamente più veloce. Torneremo su questa lezione nel capitolo «Algoritmi ricorsivi contro iterativi».
17.5 Riepilogo
I quattro problemi del capitolo coprono le tre forme tipiche di un algoritmo ricorsivo sugli array: due chiamate sulle metà con lavoro di combinazione costante (somma), due chiamate sulle metà con lavoro di combinazione lineare (Merge Sort, sotto-array di somma massima), una chiamata su una metà (ricerca binaria).
| algoritmo | ricorrenza | numero di passi | memoria extra |
|---|---|---|---|
RecursiveSum |
\(S(n)=2S(n/2)+c\) | \(7n-5=\Theta(n)\) | \(\Theta(\log_2 n)\) |
RecursiveSumLinear |
\(S(n)=S(n-1)+3\) | \(3n-1=\Theta(n)\) | \(\Theta(n)\) |
MergeSort |
\(S(n)=2S(n/2)+\Theta(n)\) | \(\Theta(n\log_2 n)\) | \(\Theta(n)\) |
RecursiveBinarySearch |
\(S(n)=S(\lfloor n/2\rfloor)+5\) | \(5(\lfloor\log_2 n\rfloor+1)+2=\Theta(\log_2 n)\) | \(\Theta(\log_2 n)\) |
FindMaximumSubarray |
\(S(n)=2S(n/2)+\Theta(n)\) | \(\Theta(n\log_2 n)\) | \(\Theta(\log_2 n)\) |
-
Correttezza: sempre per induzione forte sulla dimensione del sottoproblema; le parti non ricorsive (
Merge,FindMaxCrossingSubarray,Kadane) con invarianti di ciclo. -
La ricorsione dà un guadagno asintotico solo quando il lavoro del passo di combinazione, sommato su un livello, è piccolo rispetto a quello che fa un algoritmo iterativo (il Merge Sort rispetto agli algoritmi di ordinamento \(\Theta(n^2)\)). Per la somma e per la ricerca non dà alcun guadagno in tempo e costa memoria; per il sotto-array di somma massima il miglior algoritmo è iterativo.
Esercizi su questo capitolo: Algoritmi ricorsivi
Laboratorio interattivo
L'algoritmo del capitolo, un passo alla volta: muovi i cursori e premi ▶. Lo stesso grafico a tutta pagina, con gli altri del corso, è nel laboratorio interattivo.
-
L'esempio è tratto dal libro di testo di T. H. Cormen, C. E. Leiserson, R. L. Rivest e C. Stein, Introduction to Algorithms, Sezione 4.1. ↩